

00 Python基础 笔记
Python基础

-
在 Python 中一切皆对象
-
.py 文件怎么在Linux下运行
-
Shebang 通常在 Unix 系统脚本的中 第一行开头 使用,指明 执行这个脚本文件 的 解释程序
-
使用 Shebang 的步骤
-
使用 which 查询 python3 解释器所在路径
1
which python3
-
修改要运行的 主 python 文件,在第一行增加以下内容
1
#! /usr/bin/python3
-
修改 主 python 文件 的文件权限,增加执行权限
1
chmod +x main.py
-
在需要时执行程序即可
1
./main.py
-
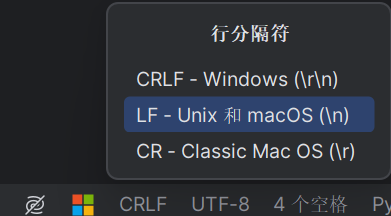
常见报错:

-
解决办法:
-
-
-
-
-
Python在 Ubuntu 中的安装
1
2
sudo apt install python3
sudo apt install ipython3-
执行 Python 程序的三种方式
-
解释器 —— python / python3
-
交互式 —— ipython
-
集成开发环境 —— PyCharm
-
1
2
3print("hello python")
# 这后面不要加 ; ,不能将两个print语句写在一行上 -
-
Python 的解释器 如今有多个语言的实现,包括:
-
CPython —— 官方版本的 C 语言实现
- 目前主流的,我们现在使用的
-
Jython —— 可以运行在 Java 平台
-
IronPython —— 可以运行在 .NET 和 Mono 平台
-
PyPy —— Python 实现的,支持 JIT 即时编译
-
-
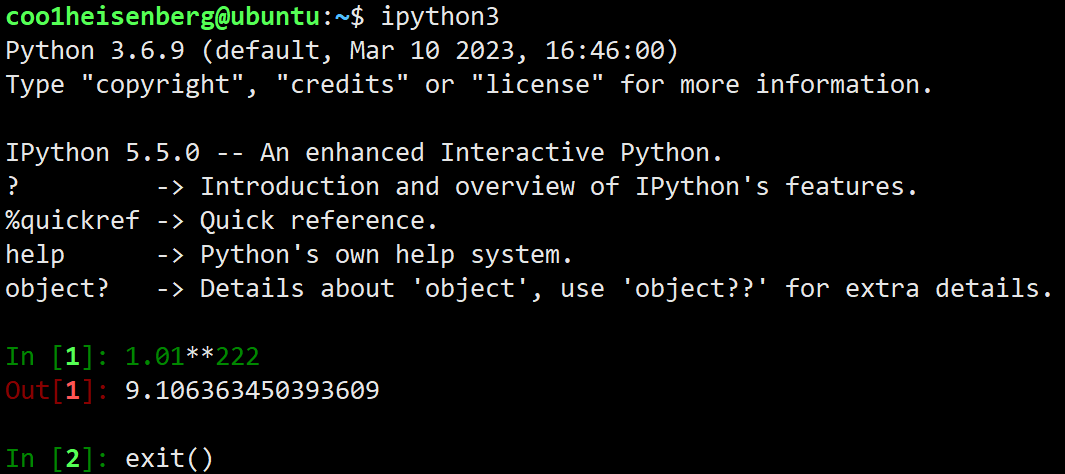
IPython
-
IPython 中 的 “I” 代表 交互 interactive
-
特点:
-
IPython 是一个 python 的 交互式 shell,比默认的 python shell 好用得多
-
支持自动补全
-
自动缩进
-
支持 bash shell 命令
-
内置了许多很有用的功能和函数
-
IPython 是基于 BSD 开源的
-
-
-
注释
- 单行注释
# - 多行注释
"""
- 单行注释
-
Python遵守的编程规范:PEP8
-
Python是区分大小写的
变量
-
在 Python 中,每个变量 在使用前都必须赋值,变量 赋值以后 该变量 才会被创建
-
等号(=)用来给变量赋值
-
= 左边是一个变量名
-
= 右边是存储在变量中的值

-
-
变量的类型
-
在内存中创建一个变量,会包括:
-
变量的名称
-
变量保存的数据
-
变量存储数据的类型
-
变量的地址(标示)
-
-
分类
-
数字型
-
整型 (int)
-
不存在整型数溢出的问题
-
二进制
bin1
2
3
4
5num=123
print(bin(123))
# 0b1111011
# 0b代表二进制 -
八进制
oct1
2
3
4
5num=123
print(oct(123))
# 0o173
# 0o代表八进制 -
十六进制
hex1
2
3
4
5num=123
print(hex(123))
# 0x7b
# 0x代表十六进制
-
-
浮点型(float)
-
布尔型(bool)
-
真 True 非 0 数 —— 非零即真,首字母要大写,假 False 0
-
布尔类型可以做数值运算
1
2i=3+True
# 结果 i 为 4
-
-
复数型 (complex)
- 主要用于科学计算
-
-
非数字型
-
字符串
-
字符串变量 之间使用 + 拼接字符串
-
字符串变量 可以和 整数 使用 ***** 重复拼接相同的字符串
-
数字型变量 和 字符串 之间 不能进行其他计算
1
2firstName = "你好"
print(10+firstName) # 不支持整形与字符串相加
-
-
列表
-
元组
-
字典
-
集合
-
-
-
-
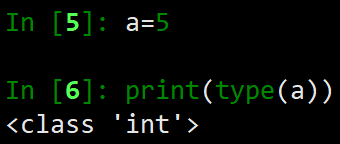
使用 type 函数可以查看一个变量的类型
-
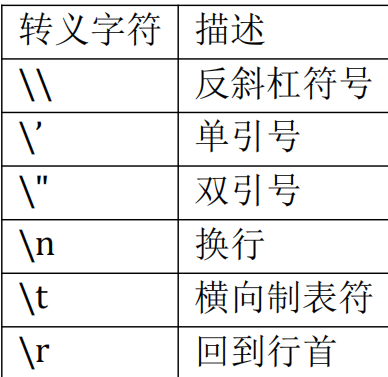
制表符
-
input 函数实现键盘输入
-
在 Python 中可以使用 input 函数从键盘等待用户的输入
-
用户输入的 任何内容 Python 都认为是一个 字符串
-
语法如下:
1
字符串变量 = input("提示信息:")
-
-
类型转换函数
int(x)- 将 x 转换为一个整数
float(x)- 将 x 转换到一个浮点数
-
变量的格式化输出
-
语法规则如下
1
2
3
4
5# 输出单个成员
print("格式化字符串" % 变量 1)
# 输出多个成员
print("格式化字符串" % (变量 1, 变量 2...))-
格式化字符
%s:字符串%d:有符号十进制整数%06d表示输出的整数显示位数,不足的地方使用 0 补全
%f:浮点数%.2f表示小数点后只显示两位
%%:输出 %
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20name="小王"
student_no=123456
price=3.2814
weight=10.234
money=price*weight
scale=0.91
print("我的名字叫 %s,请多多关照!" % name)
print("我的学号是 %06d" % student_no)
print("苹果单价 %.02f 元/斤,购买 %.02f 斤,需要支付 %.02f 元" % (price, weight, money))
print("数据比例是 %.02f%%" % (scale * 100))
"""
我的名字叫 小王,请多多关照!
我的学号是 123456
苹果单价 3.28 元/斤,购买 10.23 斤,需要支付 33.56 元
数据比例是 91.00%
"""
-
-
-
变量的命名规则
- 下划线命名法
- 驼峰命名法
- 注意:函数名、变量名和文件名应该是描述性的,尽量避免缩写
-
在 Python 中 变量 和 数据 是分开存储的
-
数据 保存在内存中的一个位置
-
变量 中保存着数据在内存中的地址
-
变量 中 记录数据的地址,就叫做 引用
-
使用 id() 函数可以查看变量中保存数据所在的 内存地址
-
如果变量已经被定义,当给一个变量赋值的时候,本质上是 修改了数据的引用
-
变量 不再 对之前的数据引用
-
变量 改为 对新赋值的数据引用
-
-
-
局部变量 和 全局变量
-
局部变量 是在 函数内部 定义的变量,只能在函数内部使用
-
局部变量的生命周期
-
所谓 生命周期 就是变量从 被创建 到 被系统回收 的过程
-
局部变量 在 函数执行时 才会被创建
-
函数执行结束后 局部变量 被系统回收
-
局部变量在生命周期 内,可以用来存储 函数内部临时使用到的数据
-
-
-
全局变量 是在 函数外部定义 的变量(没有定义在某一个函数内),所有函数内部 都可以使用这个变量
-
如果在函数中需要修改全局变量,需要使用
global进行声明1
2
3
4
5
6
7
8
9
10num = 1
def change_num():
global num
num = num + 1
change_num()
print("num = %d" % num)
# num = 2 -
在
__main__下面的是全局变量
-
-
eg:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17def demo():
num = 100
print(num)
# for 或者 while 内定义的变量在函数内均有效
for i in range(1):
num1 = 200
print(num1)
demo()
"""
100
200
"""
-
运算符
关系运算符
-
Python的除法
/默认是非整除的eg:10 / 20 = 0.5
-
取整除:
// -
幂:
**1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33# 定义一个函数,通过 def,下面是算数运算
def calc():
print(5 / 2) # 不是整除
print(5 // 2) # 是整除
print(5 % 2) # 取余 取模
print(2 ** 3) # 2的3次方
print(3 + 5 - 2) # 相同优先级从左到右
# 关系运算
def relation():
year=int(input("请输入年份"))
# 判断是闰年
print(year % 400 == 0 or year % 4 == 0 and year % 100 != 0)
# 当作程序的入口
if __name__ == '__main__':
calc()
relation()
"""
输出结果:
2.5
2
1
8
6
请输入年份 1000
False
""" -
Python支持某个数关系连写
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19def relation():
num = int(input("请输入一个数:"))
print(3 < num < 10);
# 当作程序的入口
if __name__ == '__main__':
relation()
"""
请输入一个数:4
True
请输入一个数:2
False
"""
逻辑运算符
-
and 是遇假则假,都真返回后一个
-
or 是遇真则真,否则返回前一个
1
2
3
4
5
6
7
8
9
10
11
12
13
14def logic():
print(3 and 5)
print(3 or 5)
# 当作程序的入口
if __name__ == '__main__':
logic()
"""
5
3
"""
赋值运算符
-
在 Python 中,使用
=可以给变量赋值 -
=、+=、-=、*=、/=、//=、%=、**= -
两个数进行交换,不需要第三个参数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19def exchange():
a = 3
b = 5
a, b = b, a
print("a = %d" % a)
print("b = %d" % b)
# 当作程序的入口
if __name__ == '__main__':
exchange()
"""
a = 5
b = 3
"""
Tips:
- 电信带宽:100M bit / 8 = 12.5M
- 磁盘厂商:1G = 1000 * 1000 * 1000
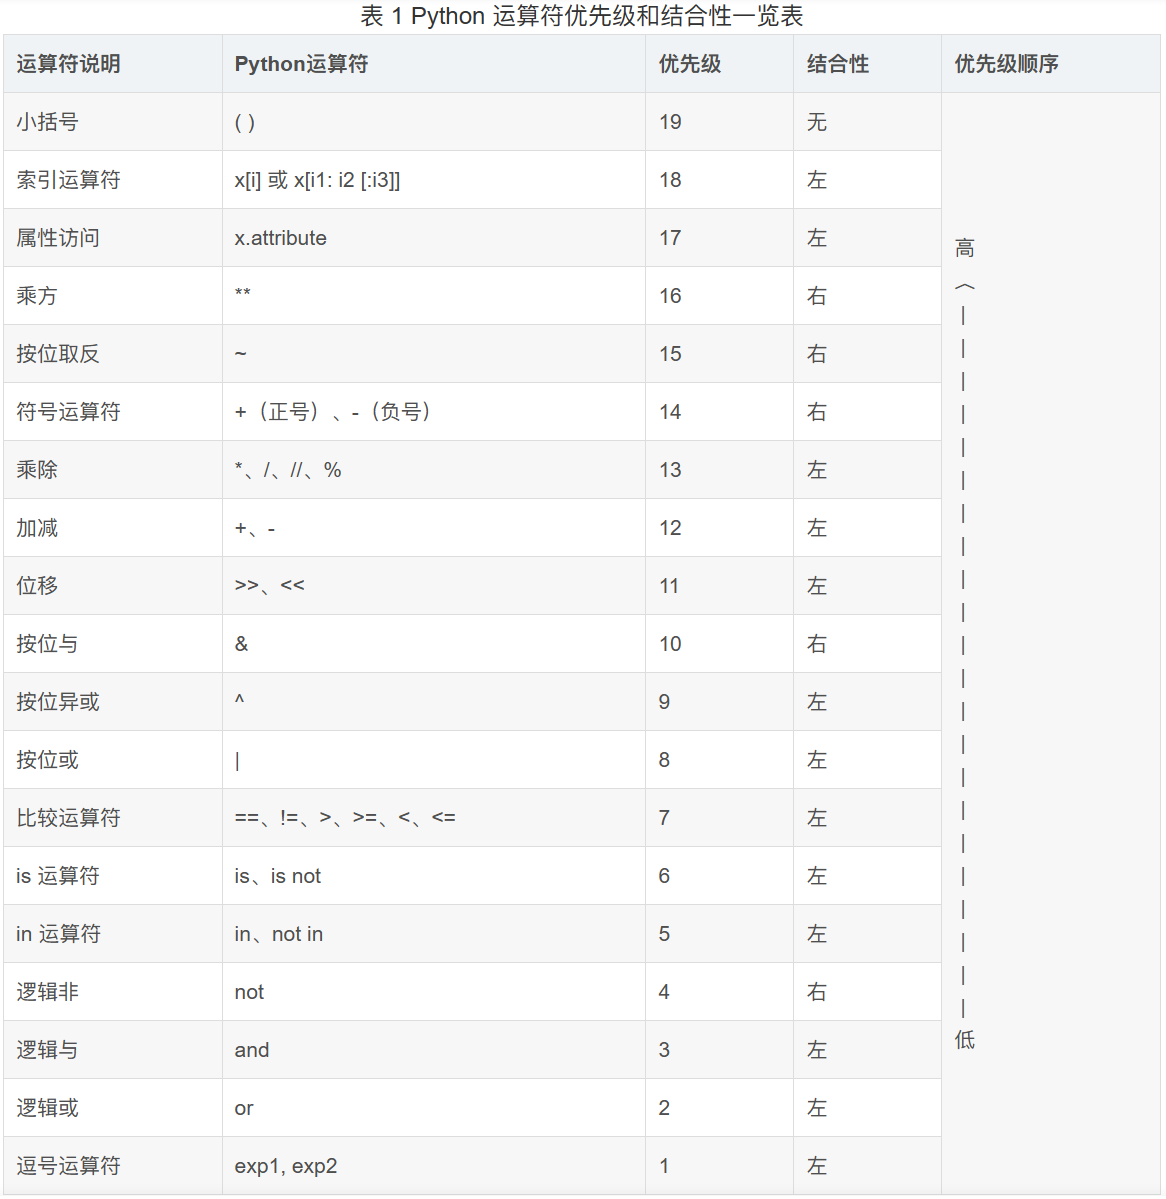
- 异或运算
- 两个相同的数异或等于 0
- eg:5 ^ 5 = 0
- 任何一个数和零异或是自身
- eg:5 ^ 0 = 5
- 两个相同的数异或等于 0
判断语句
-
if 基本语法:
1
2
3
4
5if 要判断的条件:
# 下面是4个空格
# 代码的缩进为一个 tab 键,或者 4 个空格 —— 建议使用空格
条件成立时,要做的事情
... -
not 的优先级低于 关系运算符
1
2
3
4
5
6
7
8
9
10
11
12def use_if():
score = 50
# 只要有一门成绩及格就通过
if not score > 60 or score > 60:
print("pass")
else:
print("fail")
# 当作程序的入口
if __name__ == '__main__':
use_if() -
elif 基本语法:
1
2
3
4
5
6
7
8
9
10
11
12if 条件 1:
条件 1 满足执行的代码
...
elif 条件 2:
条件 2 满足时,执行的代码
...
elif 条件 3:
条件 3 满足时,执行的代码
...
else:
以上条件都不满足时,执行的代码
... -
生成一个随机数
1
2
3
4
5
6
7
8import random
def randomNumber():
num = random.randint(12, 20); # 生成的随机范围:12 <= num <= 20
print("随机数: %d" % num)
if __name__ == '__main__':
randomNumber()
循环语句
-
while 语句基本语法
1
2
3
4
5while 条件(判断 计数器 是否达到 目标次数):
条件满足时,做的事情 1
条件满足时,做的事情 2
条件满足时,做的事情 3
...(省略)... 处理条件(计数器 + 1) -
判断程序是在死循环还是在 input:通过cpu占用率来看,如果cpu占用率为0,那么是input,如果cpu占用率很高,就是死循环
1
2
3
4
5
6
7
8
9
10
11def cal_sum():
i = 0
result = 0
while i <= 100:
result += i
i += 1
print("0 ~ 100 之间的数字求和结果:%d" % result)
if __name__ == '__main__':
cal_sum() -
break 和 continue
-
break 和 continue 是专门在循环中使用的关键字
- break 某一条件满足时,退出循环,循环结束,不再执行后续重复的代码
- continue 某一条件满足时,不执行后续循环内部的代码,开始下一轮循环
-
break 和 continue 只针对 当前所在循环 有效
-
-
end = "\t"- 表示输出结果后,不换行
- “\t” 可以在控制台输出一个制表符,协助在输出文本时对其
-
for 循环
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24def use_for():
a = [1, 2, 3]
for i in a:
print(i , end = " ")
# 在每输出的数后面加一个空格
def use_for_range():
for i in range(1, 4):
print(i , end = " ")
if __name__ == '__main__':
use_for()
print("\n------")
use_for_range()
"""
1 2 3
------
1 2 3
"""
函数基础
-
Python中一切皆对象
-
定义函数的格式:
1
2
3def 函数名():
函数封装的代码
...-
def 是英文 define 的缩写
-
函数名称 应该能够表达 函数封装代码 的功能,方便后续的调用
-
函数名称 的命名应该 符合 标识符的命名规则
-
可以由 字母、下划线 和 数字 组成
-
不能以数字开头
-
不能与关键字重名
-
-
-
函数参数的使用
- 在函数名的后面的小括号内部填写 参数
- 多个参数之间使用 , 分隔
1
2
3
4
5
6def sum_2_num(num1, num2):
result = num1 + num2;
print("%d + %d = %d" % (num1, num2, result))
if __name__ == '__main__':
sum_2_num(10, 20) -
函数的嵌套调用
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17def sum_2_num(num1, num2):
result = num1 + num2;
return result
def sum_plus_sum():
result = sum_2_num(1, 2)
result += 1;
return result
if __name__ == '__main__':
print("result = %d" % sum_plus_sum())
# result = 4 -
使用模块中的函数
-
模块是 Python 程序架构的一个核心概念
1
import xxx
- 一切py文件皆模块
- 并且不能以数字开头
-
模块 就好比是 工具包,要想使用这个工具包中的工具,就需要 导入 import这个模块
-
每一个以扩展名 py 结尾的 Python 源代码文件都是一个 模块
-
在模块中定义的 全局变量 、 函数 都是模块能够提供给外界直接使用的工具
-
-
Pyc 文件
-
C 是 compiled 编译过 的意思
-
Python 在解释源程序时是分成两个步骤的
-
首先处理源代码,编译 生成一个二进制 字节码
-
再对 字节码 进行处理,才会生成 CPU 能够识别的 机器码
有了模块的字节码文件之后,下一次运行程序时,如果在 上次保存字节码之****后 没有修改过源代码,Python 将会加载 .pyc 文件并跳过编译这个步骤
-
-
-
在 Python 中,函数的 实参/返回值 都是是靠 引用 来传递来的
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27def test(num):
print("-" * 50)
print("%d 在函数内的内存地址是 %x" % (num, id(num)))
result = 100
print("返回值 %d 在内存中的地址是 %x" % (result, id(result)))
print("-" * 50)
return result
def big_int_id():
a = -300
print("a 的地址:%x" % id(a))
b = -300
print("b 的地址:%x" % id(b))
a = 10
print("调用函数前 内存地址是 %x" % id(a))
r = test(a) # a 的值不会发生改变
"""
调用函数前 内存地址是 278a6b06a50
--------------------------------------------------
10 在函数内的内存地址是 278a6b06a50
返回值 100 在内存中的地址是 278a6b355d0
--------------------------------------------------
"""- Python会把一些比较小的数或者那些比较常用的数 (-5 ~ 256)提前存储在内存中,如果你取出的数字在这个范围内,每次标号都指向你要取出的数
- int 清楚写了
[-5, 256],这些小整数被定义在这个对象池中,所以当引用小整数时会自动引用整数对象池里的对象 - 好处:每次去初始化这些小整数变量,速度很快,无需构造数值对象
- int 清楚写了
- Python 一个数值默认占用的空间是 28 个字节
- float类型可以认为每个赋值都是创建一个对象。因为float有点多,所以没必要和int一样了
- Python会把一些比较小的数或者那些比较常用的数 (-5 ~ 256)提前存储在内存中,如果你取出的数字在这个范围内,每次标号都指向你要取出的数
-
可变和不可变类型
-
不可变类型,内存中的数据不允许被修改:
-
不可变类型只能通过赋值运算符对其直接赋值,这样地址会发生改变
-
数字类型 int, bool, float, complex, long(2.x)
-
字符串 str
-
元组 tuple
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36def use_tuple():
demo_tuple = (1, 2, 3)
print(id(demo_tuple))
demo_tuple = (1, 2, 4)
print(id(demo_tuple))
if __name__ == '__main__':
use_tuple()
"""
1844313522048
1844314724736
"""
def use_same_tuple():
demo_tuple1 = (1, 2, 3)
print(id(demo_tuple1))
demo_tuple2 = (1, 2, 3)
print(id(demo_tuple2))
if __name__ == '__main__':
use_same_tuple()
"""
3127796404416
3127796404416
"""
-
-
可变类型,内存中的数据可以被修改:
-
可变类型就是无论是通过 append、pop、remove、list[i]赋值 等都不会改变原本可变类型的地址
-
可变数据类型可以在子函数中通过其接口修改数据空间中的值
-
列表 list
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27"""
函数中去改变函数外某个变量值
"""
demo_list = [1, 2, 3] # demo_list 是一个列表
print(demo_list)
print("demo_list 列表的内存地址:%d" % id(demo_list))
print(demo_list[0])
print(demo_list[1])
print(demo_list[2])
demo_list[0] = 10
print("demo_list 列表改变后的内存地址:%d" % id(demo_list))
"""
demo_list 列表的内存地址:1948616577664
1
2
3
demo_list 列表改变后的内存地址:1948616577664
""" -
字典 dict
-
集合 set
-
-
-
哈希 (hash)
-
Python 中内置有一个名字叫做 hash(o) 的函数
-
接收一个 不可变类型 的数据作为 参数
-
返回 结果是一个 整数
-
-
哈希 是一种 算法,其作用就是提取数据的 特征码(指纹)
-
相同的内容 得到 相同的结果
-
不同的内容 得到 不同的结果
-
-
在 Python 中,设置字典的 键值对 时,会首先对 key 进行 hash 已决定如何在内存中保存字典的数据,以方便 后续 对字典的操作:增、删、改、查
-
键值对的 key 必须是不可变类型数据
-
键值对的 value 可以是任意类型的数据
-
-
高级变量类型
目标
- 列表
- 元组
- 字典
- 字符串
- 集合
在 Python 中,所有 非数字型变量 都支持以下特点:
-
都是一个 序列 sequence,也可以理解为 容器
-
取值 [ ]
-
遍历 in
-
计算长度、最大/最小值、比较、删除
-
链接 + 和 重复
-
切片
列表
- List(列表) 是 Python 中使用 最频繁 的数据类型,在其他语言中通常叫做数组
- 专门用于存储 一串 信息
- 列表用
[]定义,数据 之间使用,分隔 - 列表的 索引 从 0 开始
- 列表的使用场景
- 列表 中可以 存储不同类型的数据
- 通过 迭代遍历,在循环体内部,针对列表中的每一项元素,执行相同的操作
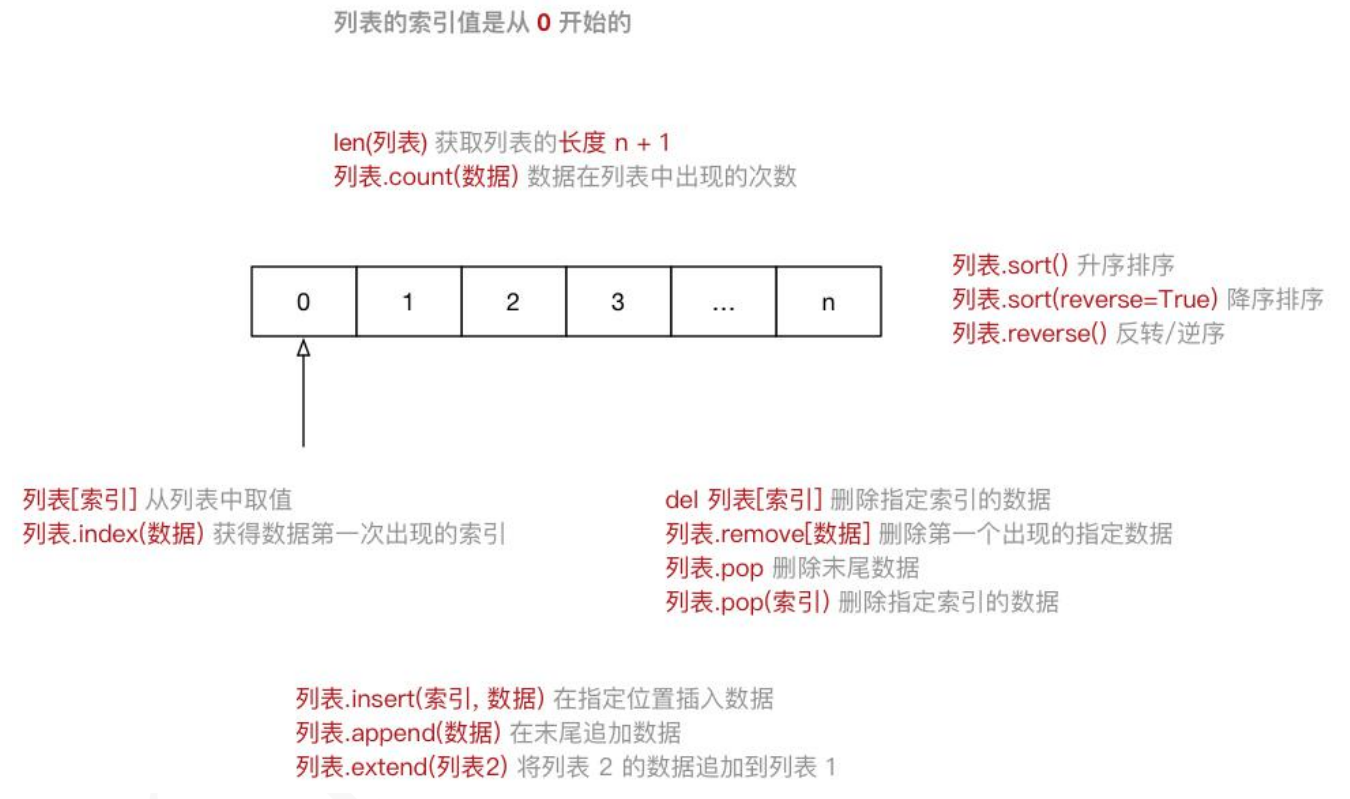
| 序号 | 分类 | 关键字 / 函数 / 方法 | 说明 |
|---|---|---|---|
| 1 | 增加 | 列表.insert(索引, 数据) | 在指定位置插入数据 |
| 列表.append(数据) | 在末尾追加数据 | ||
| 列表.extend(列表 2) | 将列表 2 的数据追加到列表 | ||
| 2 | 修改 | 列表[索引] = 数据 | 修改指定索引的数据 |
| 3 | 删除 | del 列表[索引] | 删除指定索引的数据 |
| 列表.remove(数据) | 删除第一个出现的指定数据 | ||
| 列表.pop | 删除末尾数据 | ||
| 列表.pop(索引) | 删除指定索引的数据 | ||
| 列表.clear | 清空列表 | ||
| del 列表[索引] | del会删除指定的元素,与pop功能一致 | ||
| 4 | 统计 | len(列表) | 列表长度 |
| 列表.count(数据) | 数据在列表中出现的次数 | ||
| index | 搜某个值的索引值 | ||
| 5 | 排序 | 列表.sort() | 升序排序 |
| 列表.sort(reverse=True) | 降序排序 | ||
| 列表.reverse() | 逆序、反转(本身不做排序操作),不可以传参 | ||
| 默认使用的算法是 归并排序 |
eg:
1 | name_list = ["zhangsan", "lisi", "wangwu"] |
列表生成式
-
列表推导式:用来快速地生成列表
- 好处:代码比较短
- 坏处:可读性差
1
[元素表达式 if(条件) else for 变量 in 迭代对象 ]
eg:
1 | a = [x for x in range(10)] |
元组
-
Tuple(元组)与列表类似,不同之处在于元组的 元素不能修改
- 元组 表示多个元素组成的序列
- 元组 在 Python 开发中,有特定的应用场景
-
用于存储 一串 信息,数据 之间使用
,分隔 -
元组用
()定义 -
元组的 索引 从 0 开始
-
元组的应用场景
- 函数的 参数 和 返回值,一个函数可以接收 任意多个参数,或者 一次返回多个数据
- 格式字符串,格式化字符串后面的 () 本质上就是一个元组
- 列表不可以被修改,以保护数据安全
-
元组中 只包含一个元素 时,需要 在元素后面添加
,,不加逗号就是整型元素1
info_tuple = (50, )
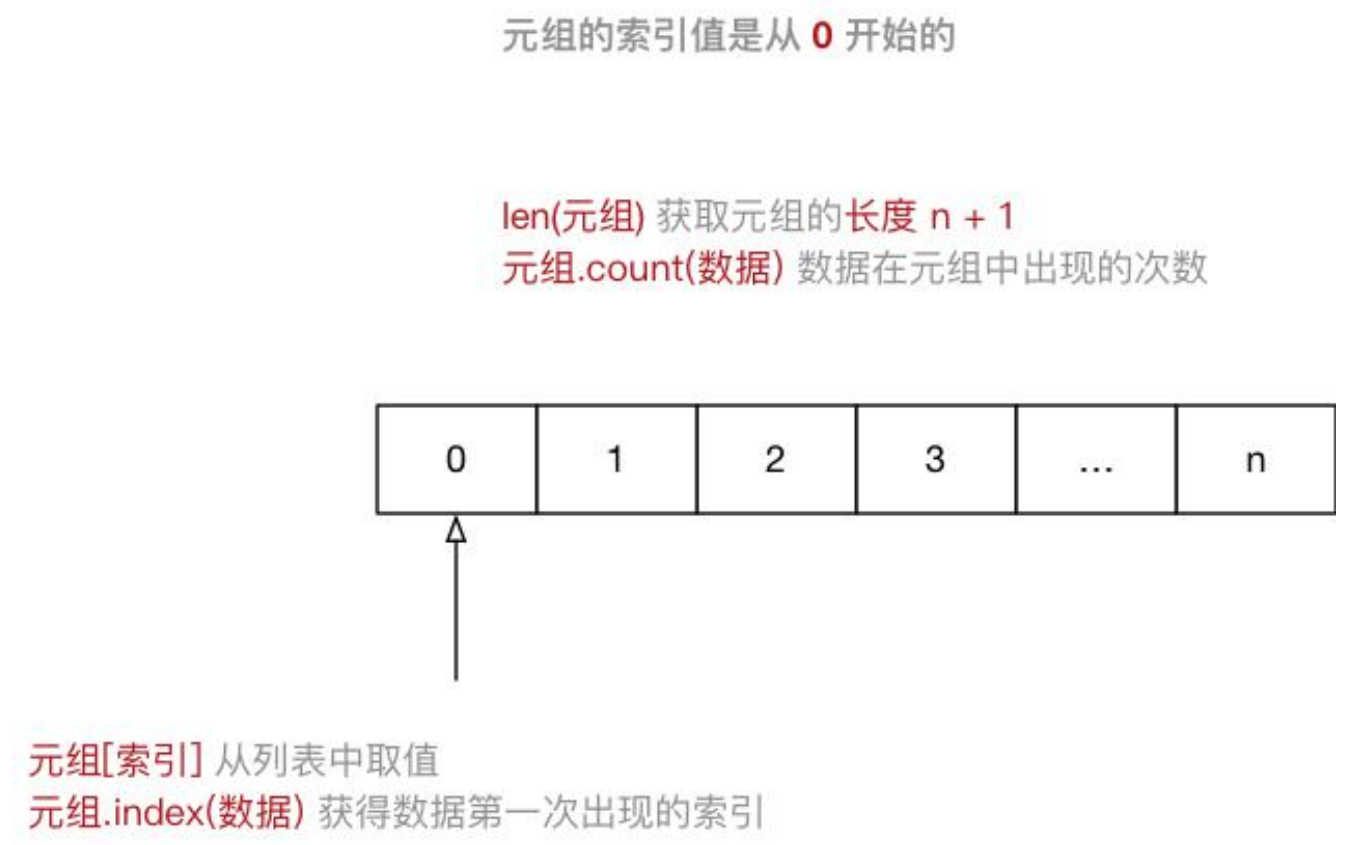
eg:
1 | info_tuple = ("zhangsan", 18, 1.75, "zhangsan") |
格式化字符串
1 | info_tuple = ("zhangsan", 18, 1.75) |
元组和列表之间的转换
- 使用 list 函数可以把元组转换成列表
- list(元组)
- 使用 tuple 函数可以把列表转换成元组
- tuple(列表)
1 | info = ("zhangsan", 18) |
字典
- dictionary(字典) 是 除列表以外 Python 之中 最灵活 的数据类型
- 字典同样可以用来 存储多个数据
- 通常用于存储 描述一个 物体 的相关信息
- 和列表的区别
- 列表 是 有序 的对象集合
- 字典 是 无序 的对象集合
- 字典用
{}定义 - 字典使用 键值对 存储数据,键值对之间使用
,分隔- 键 key 是索引
- 值 value 是数据
- 键 和 值 之间使用
:分隔 - 键必须是唯一的
- 值 可以取任何数据类型,但 键 只能使用 字符串、数字或 元组
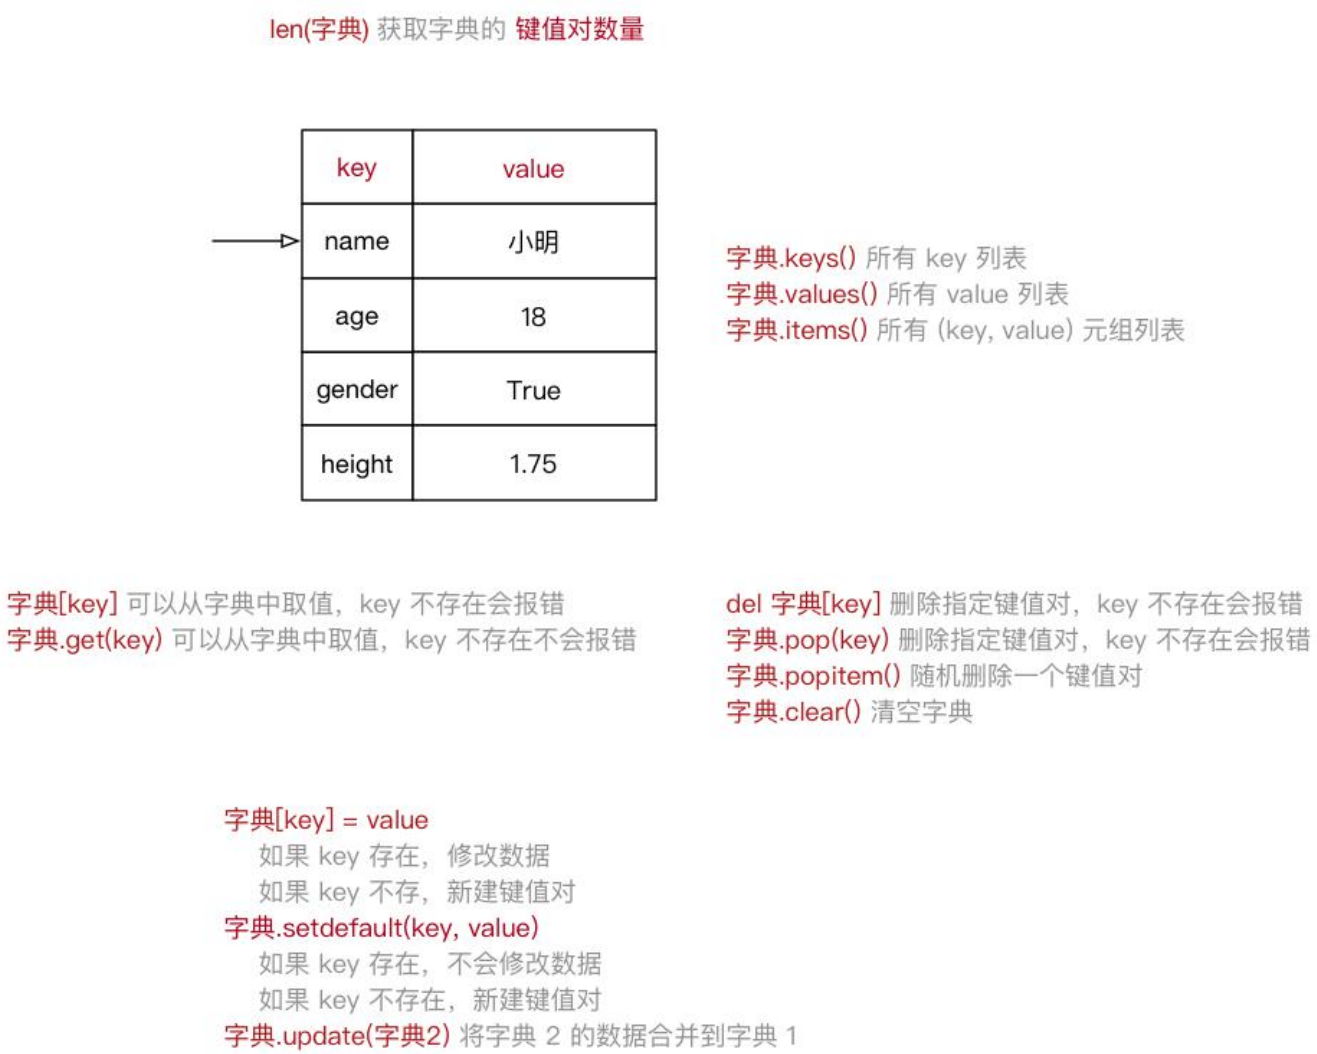
eg:
1 | # 对字典进行增删查改 |
字符串
- 字符串 就是 一串字符,是编程语言中表示文本的数据类型
- 在 Python 中可以使用 一对双引号 " 或者 一对单引号 ’ 定义一个字符串
- 虽然可以使用
\"或者\'做字符串的转义,但是在实际开发中- 如果字符串内部需要使用
",可以使用'定义字符串 - 如果字符串内部需要使用
',可以使用"定义字符串
- 如果字符串内部需要使用
- 虽然可以使用
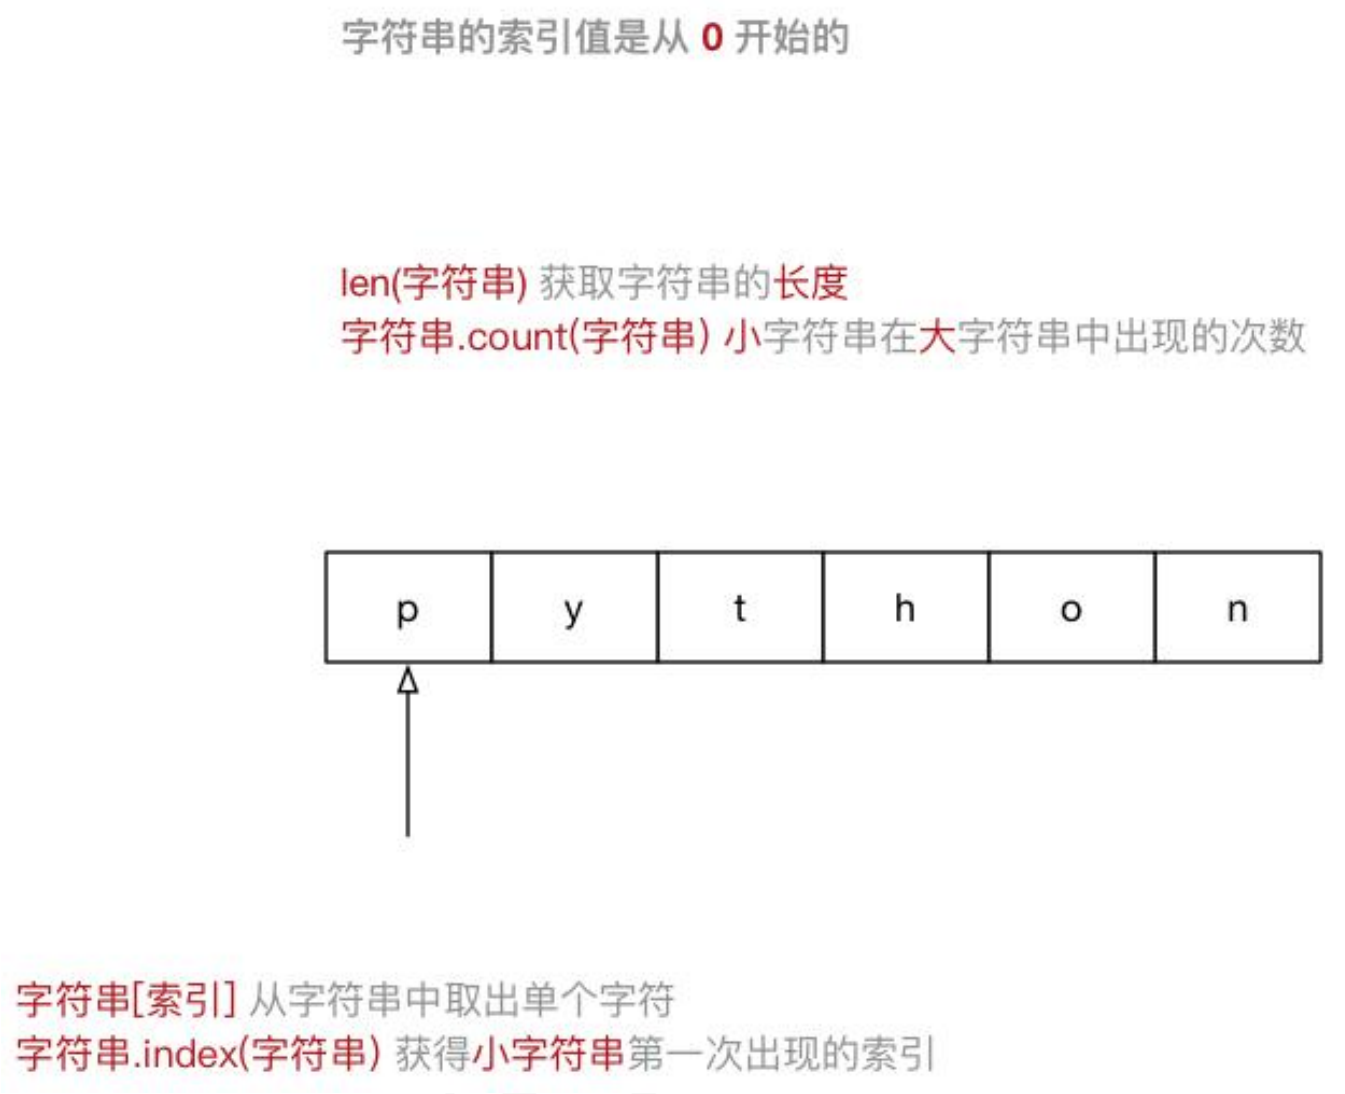
- 可以使用 索引 获取一个字符串中 指定位置的字符,索引计数从 0 开始
- 也可以使用 循环遍历 字符串中每一个字符
判断类型
| 方法 | 说明 |
|---|---|
| string.isspace() | 如果 string 中只包含空格,则返回True |
| string.isalnum() | 如果 string 至少有一个字符并且所有,字符都是字母或数字则返回 True |
| string.isalpha() | 如果 string 至少有一个字符并且所有,字符都是字母则返回 True |
| string.isdecimal() | 如果 string 只包含数字则返回 True |
| string.islower() | 如果 string 中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是小写,则返回 True |
查找与替换
- 可以用正则表达式
| 方法 | 说明 |
|---|---|
| string.startswith(str) | 检查字符串是否是以 str 开头,是则返回True |
| string.endswith(str) | 检查字符串是否是以 str 结束,是则返回True |
| string.find(str, start=0, end=len(string)) | 检测 str 是否包含在 string 中,如果start 和 end 指定范围,则检查是否包含在指定范围内,如果是返回开始的索引值,否则返回 -1 |
| string.rfind(str, start=0, end=len(string)) | 类似于 find(),不过是从右边开始查找 |
| string.index(str, start=0, end=len(string)) | 跟 find() 方法类似,不过如果 str 不在 string 会报错 |
| string.rindex(str, start=0, end=len(string)) | 类似于 index(),不过是从右边开始 |
| string.replace(old_str, new_str, num=string.count(old)) | 把 string 中的 old_str 替换成new_str,如果 num 指定,则替换不超过 num 次 c.replace(“world”,“china”,2) |
大小写转换
| 方法 | 说明 |
|---|---|
| string.lower() | 转换 string 中所有大写字符为小写 |
| string.upper() | 转换 string 中的小写字母为大写 |
| string.swapcase() | 翻转 string 中的大小写(大写变小写,小写变大写) |
文本对齐
| 方法 | 说明 |
|---|---|
| string.ljust(width) | 返回一个原字符串左对齐,并使用空格填充至长度 width 的新字符串 |
| string.rjust(width) | 返回一个原字符串右对齐,并使用空格填充至长度 width 的新字符串 |
| string.center(width) | 返回一个原字符串居中,并使用空格填充至长度 width 的新字符串 |
去除空白字符
| 方法 | 说明 |
|---|---|
| string.lstrip(char) | 截掉 string 左边(开始)的空白字符,可以去除字符 char |
| string.rstrip(char) | 截掉 string 右边(开始)的空白字符,可以去除字符 char |
| string.strip(char) | 截掉 string 左右两边(开始)的空白字符,可以去除字符 char |
拆分与连接
| 方法 | 说明 |
|---|---|
| string.split(str=“”, num) | 以 str 为分隔符拆分 string,如果num 有指定值,则仅分隔 num + 1个子字符串,str 默认包含空格、中文逗号和英文逗号 |
| string.splitlines() | splitlines 只是换行,每行字符串的内容不做修改 |
| string.join(seq) | 以 string 作为分隔符,将 seq 中所有的字符以 string 分割开 |
字符串的切片
-
切片 方法适用于 字符串、列表、元组
- 切片 使用 索引值 来限定范围,从一个大的 字符串 中 切出 小的 字符串
- 列表 和 元组 都是 有序 的集合,都能够 通过索引值 获取到对应的数据
- 字典 是一个 无序 的集合,是使用 键值对 保存数据
-
语法:
1
字符串[开始索引:结束索引:步长]
-
注意:
-
指定的区间属于 左闭右开 型 [开始索引,结束索引) => 开始索引 <= 范围 <
结束索引
从 起始 位开始,到 结束位的前一位结束(不包含结束位本身)
-
从头开始,开始索引 数字可以省略,冒号不能省略
-
到末尾结束,结束索引 数字可以省略,冒号不能省略
-
步长默认为 1,如果连续切片,数字和冒号都可以省略
-
-
1 | str1 = "python" |
集合
-
集合里面不能有重复元素,必须是唯一的
-
定义一个空集合
1
demo_set=set()
| 方法 | 说明 |
|---|---|
| add() | 为集合添加元素 |
| clear() | 移除集合中的所有元素 |
| copy() | 拷贝一个集合 |
| difference() | 返回多个集合的差集 |
| difference_update() | 移除集合中的元素,该元素在指定的集合也存在 |
| discard() | 删除集合中指定的元素 |
| intersection() | 返回集合的交集 |
| intersection_update() | 返回集合的交集,直接在指定集合上进行更新 |
| isdisjoint() | 判断两个集合是否包含相同的元素,如果没有返回 True,否则返回 false |
| issubset() | 判断指定集合是否为该方法参数集合的子集 |
| issuperset() | 判断该方法的参数集合是否为指定集合的子集 |
| remove() | 移除指定元素 |
| symmetric_difference() | 返回两个集合中不重复的元素集合 |
| symmetric_difference_update() | 移除当前集合中在另外一个指定集合相同的元素,并将另外一个指定集合中不同的元素插入到当前集合中 |
| union() | 返回两个集合的并集 |
| update() | 给集合添加元素 |
eg:
1 | x = {"apple", "banana", "cherry"} |
difference_update() 方法与 difference() 方法的区别在:
-
difference() 方法返回一个移除相同元素的新集合,
-
difference_update() 方法是直接在原来的集合中移除元素,没有返回值。
intersection_update() 方法不同于 intersection() 方法:
-
intersection() 方法是返回一个新的集合,
-
intersection_update() 方法是在原始的集合上移除不重叠的元素。
公共方法
Python内置函数
| 函数 | 描述 | 备注 |
|---|---|---|
| len(item) | 计算容器中元素个数 | |
| del(item) | 删除变量 | del 有两种方式(列表,字典,集合) |
| max(item) | 返回容器中元素最大值 | |
| min(item) | 返回容器中元素最小值 |
切片
- 表达式
- eg:
[::-2]
- eg:
- 支持的数据类型(都是无序的集合,通过 索引值 获取对应数据)
- 字符串
- 列表
- 元组
- 不支持的数据类型(都是有序的集合,通过 键值对 保存数据)
- 字典
- 集合
运算符
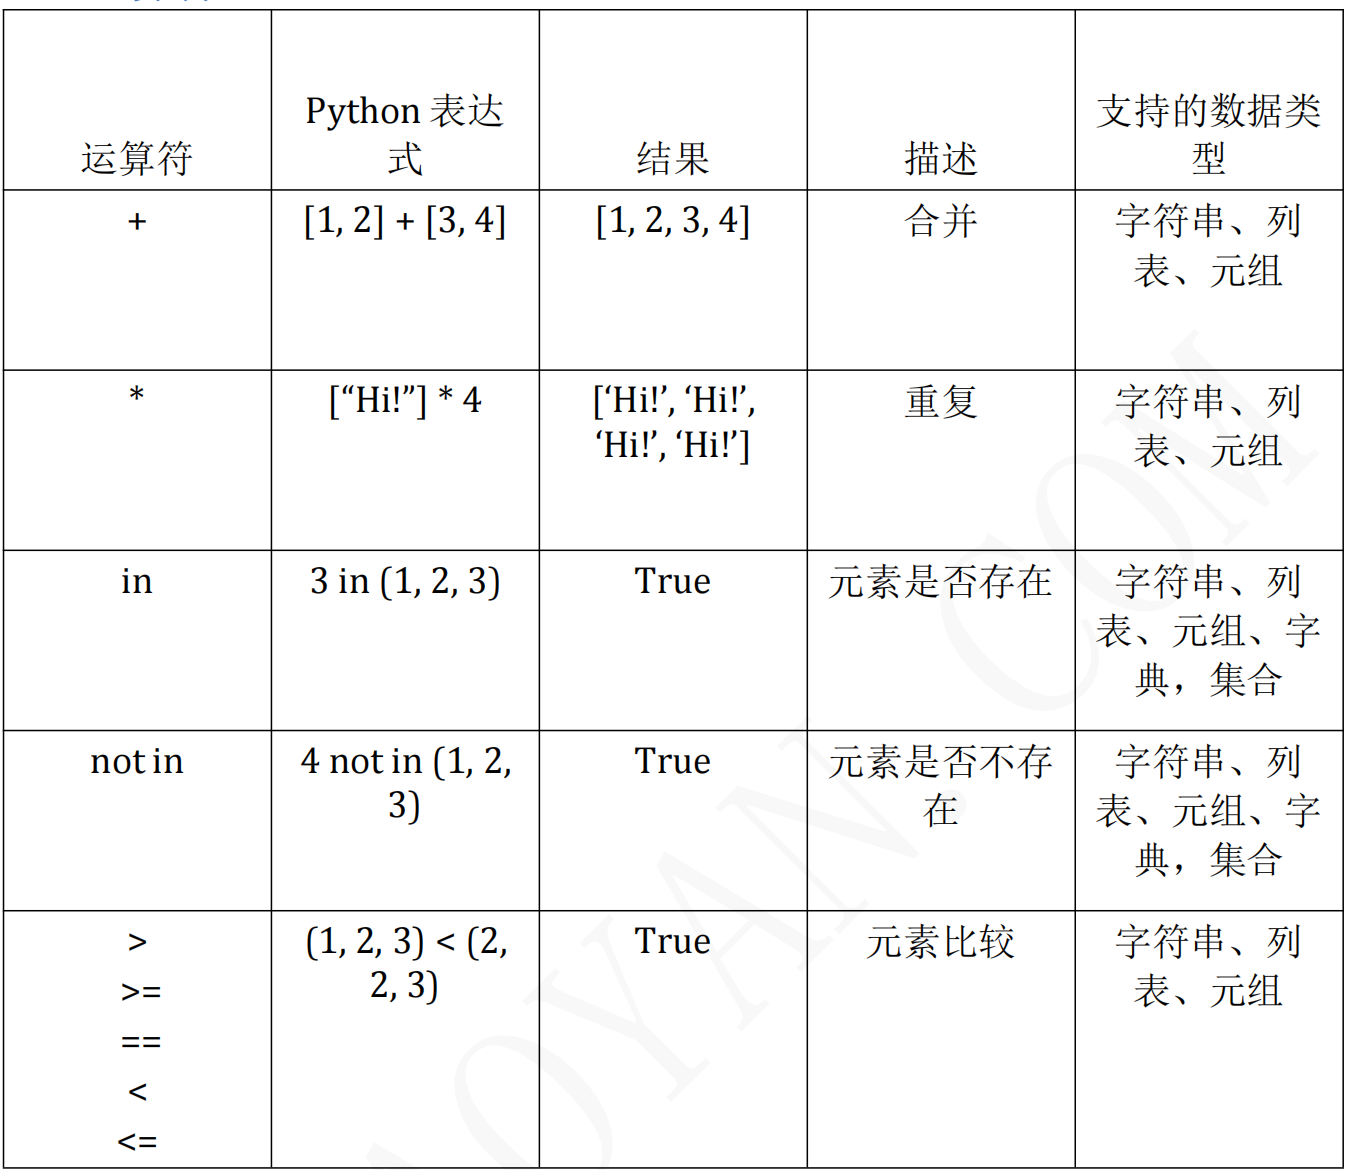
eg:
1 | a = [0] * 10 |
成员运算符
- 用于 测试 序列中是否包含指定的 成员
| 运算符 | 描述 | 实例 |
|---|---|---|
| in | 如果在指定的序列中找到值返回True,否则返回False | 3 in (1, 2, 3) 返回 True |
| not in | 如果在指定的序列中没有找到值返回True,否则返回False | 3 not in (1, 2, 3) 返回 False |
- 在对 字典 操作时,判断的是 字典的键
函数进阶
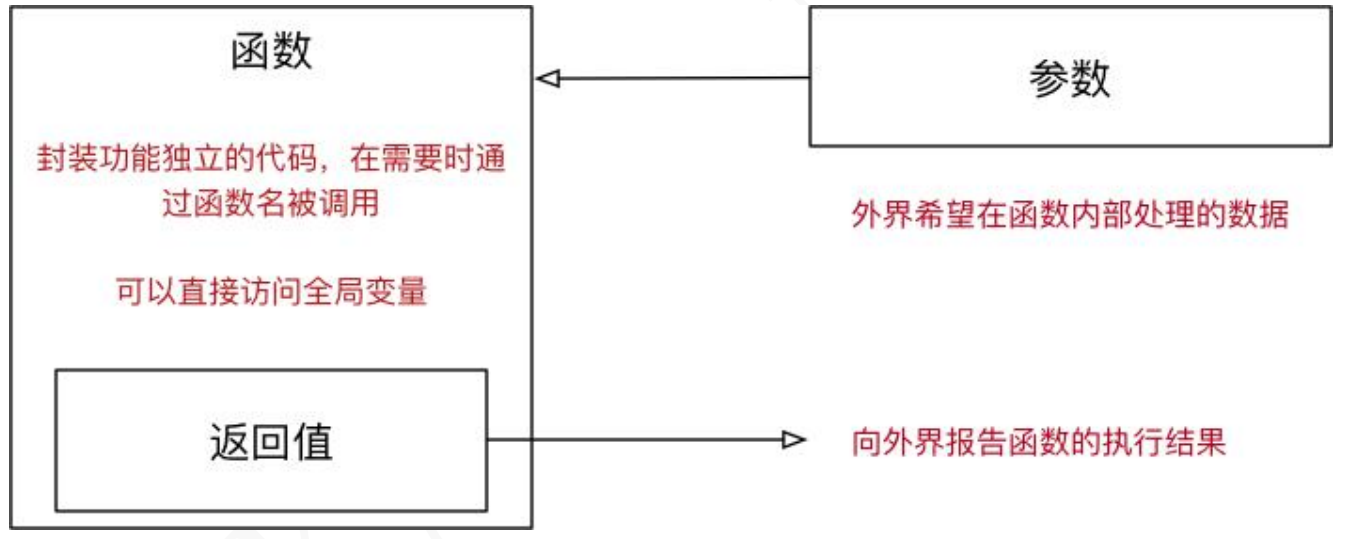
- 无参数,无返回值
- 无参数,有返回值
- 有参数,无返回值
- 有参数,有返回值
1 | # 返回值 加还是不加() 返回的都是一个元组 |
交换两个数的值
-
解法 1 —— 使用其他变量
1
2
3tmp = b
b = a
a = tmp -
解法 2 —— 不使用临时变量
1
2
3a = a + b
b = a - b
a = a - b -
解法 3 —— Python 专有,利用元组
1
a, b = b, a
可变参数与不可变参数
-
+=
- 在 python 中,列表变量调用 += 本质上是在执行列表变量的 extend 方法,不会修改变量的引用,就是变量的 id 值没变
1
2
3
4
5
6
7
8
9
10
11
12
13
14
def mutable(num_list):
num_list += [1, 2, 3]
# num_list.extend([1, 2, 3])
print(num_list)
gl_list = [6, 7, 8]
mutable(gl_list)
print(gl_list)
"""
[6, 7, 8, 1, 2, 3]
[6, 7, 8, 1, 2, 3]
"""
缺省参数
-
指定函数的缺省参数
- 在参数后使用赋值语句,可以指定参数的缺省值
1
2
3
4
5
6
7
8
9
10
11
12# 缺省参数指传参时可以不传对应的参数
def print_info(name, gender=True):
gender_text = "男生"
if not gender:
gender_text = "女生"
print("%s 是 %s" % (name, gender_text))
if __name__ == '__main__':
print_info("zhaosi") # zhaosi 是 男生
print_info("zhaosi", False) # zhaosi 是 女生 -
缺省参数的定义位置
-
必须保证 带有默认值的缺省参数 在参数列表末尾
1
2
3
4def print_info(name, gender=True, title):
# 这个是 错误 的
# 缺省参数只能放在 最后
-
多值参数
-
有时可能需要 一个函数 能够处理的参数 个数 是不确定的,这个时候,就可以使用 多值参数
-
python 中有 两种 多值参数:
-
参数名前增加 一个 * 可以接收 元组
-
参数名前增加 两个 * 可以接收 字典
-
-
一般在给多值参数命名时,习惯使用以下两个名字
-
*args—— 存放 元组 参数,前面有一个 * -
**kwargs—— 存放 字典 参数,前面有两个 *
-
-
args 是 arguments 的缩写,有变量的含义
-
kw 是 keyword 的缩写,kwargs 可以记忆 键值对参数
-
*args必须在**kwargs前面
1 | # 可变参数 也叫 多值参数 |
解包(unpack)
-
在调用带有多值参数的函数时,如果希望:
-
将一个 元组变量,直接传递给 args
-
将一个 字典变量,直接传递给 kwargs
-
-
就可以使用 拆包,简化参数的传递,拆包 的方式是:
-
在 元组变量前,增加 一个
*- 效果就是把 (1, 2, 3, 4) 会变成 1, 2, 3, 4
-
在 字典变量前,增加 两个
*- 效果就是把 {‘name’: ‘小明’, ‘age’: 18} 变为 name = ‘小明’, age = 18
-
1 | def demo(*args, **kwargs): |
Python面向对象编程
Python 命名规范
| 名称 | 写法 |
|---|---|
| 模块名 | module_name |
| 包名 | package_name |
| 方法名 | method_name |
| 异常名 | ExceptionName |
| 函数名 | function_name |
| 全局常量名 | GLOBAL_CONSTANT_NAME |
| 全局变量名 | global_var_name |
| 实例名 | instance_var_name |
| 函数参数名 | function_parameter_name |
| 局部变量名 | local_var_name |
让Python指向Python3.6:
1 | sudo ln -s /usr/bin/python3.6 /usr/bin/python |
面向对象的基础语法
dir 内置函数
-
在Python中 对象是无处不在的, 变量、数据、函数 都是对象
-
object类是基类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19# object 是 基类
class Person(object):
def __init__(self, name, age, height):
self.name = name
self.age = age
self.height = height
def run(self):
print("%s is running" % self.name)
def eat(self):
print("%s is eating" % self.name)
if __name__ == '__main__':
# 初始化一个对象时会调用 __init__
person = Person("John", 18, 187);
person.run()
person.eat() -
提示 方法名 格式的方法是 Python 提供的 内置方法 / 属性
序号 方法名 类型 作用 1 __new__方法 创建对象时,会被 自动 调用 2 __init__方法 对象被初始化时,会被 自动 调用 3 __del__方法 对象被从内存中销毁前,会被 自动 调用 4 __str__方法 返回对象的描述信息,print 函数输出使用 - 利用好 dir() 函数
定义简单的类
定义指包含方法的类
-
在 Python 中要定义一个只包含方法的类,语法格式如下:
1
2
3
4
5
6class 类名:
def 方法 1(self, 参数列表):
pass
def 方法 2(self, 参数列表):
pass-
第一个参数必须是 self
-
由 哪一个对象 调用的方法,方法内的 self 就是 哪一个对象的引用
-
在类封装的方法内部,self 就表示 当前调用方法的对象自己
-
在方法内部
-
可以通过 self. 访问对象的属性
-
也可以通过 self. 调用其他的对象方法
-
-
-
创建对象
- 对象变量 = 类名()
初始化方法
- 当使用 类名() 创建对象时,会 自动 执行以下操作
- 为对象在内存中 分配空间 —— 创建对象
- 为对象的属性 设置初始值 —— 初始化方法(init)
- 这个 初始化方法 就是
__init__方法,__init__是对象的内置方法- 在
__init__方法内部使用 self.属性名 = 属性的初始值 就可以 定义属性 - 定义属性之后,再使用 类创建的对象,都会拥有该属性
- 在
- 这个 初始化方法 就是
内置的方法及和属性
-
__del__方法- 在Python中,使用 类名() 创建对象时,为对象 分配完空间后,自动 调用
__init__方法 - 当一个 对象被从内存中销毁 前,会 自动 调用
__del__方法 __del__如果希望在对象被销毁前,再做一些事情,可以考虑一下__del__
- 在Python中,使用 类名() 创建对象时,为对象 分配完空间后,自动 调用
-
__str__方法__str__方法必须返回一个字符串- 打印对象得到的是该函数 return 的内容
- 在 Python 中,使用 print 输出 对象变量,默认情况下,会输出这个变量 引用的对象 是 由哪一个类创建的对象,以及 在内存中的地址(十六进制表示)
- 在开发中,希望使用 print 输出 对象变量 时,能够打印 自定义的内容,就可以利用
__str__这个内置方法了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25class Cat:
def __init__(self, new_name):
self.name = new_name
print("%s 来了" % self.name)
# 对象销毁的时候会调用
def __del__(self):
print("%s 我去了" % self.name)
# 打印对象调用这个
def __str__(self):
# 必须返回一个字符串
# 必须有 return
return "我是小猫[%s]" % self.name
tom=Cat("Tom")
print(tom)
"""
Tom 来了
我是小猫[Tom]
Tom 我去了
"""
面向对象的封装
-
封装
-
封装 是面向对象编程的一大特点
-
面向对象编程的 第一步 —— 将 属性 和 方法 封装 到一个抽象的 类 中
-
外界 使用 类 创建 对象,然后 让对象调用方法
- 对象方法的细节 都被 封装 在 类的内部
-
-
添加注解

1 | class HouseItem: |
-
定义没有初始值的属性
-
在定义属性时,如果 不知道设置什么初始值,可以设置为 None
-
None 关键字 表示 什么都没有,表示一个 空对象,没有方法和属性,是一个特殊的常量
-
可以将 None 赋值给任何一个变量
-
身份运算符
-
身份运算符用于 比较 两个对象的 内存地址 是否一致 —— 是否是对同一个对象的引用
-
在 Python 中针对 None 比较时,建议使用 is 判断
运算符 描述 实例 is is 是判断两个标识符是不是引用同一个对象 x is y,类似于 id(x) == id(y) is not is not 是判断两个标识符是不是引用不同对象 x is not y,类似id(x) != id(y)
is 与 == 区别:
- is 用于判断 两个变量 引用对象是否为同一个,就是地址是不是一样的
- == 用于判断 引用变量的值 是否相等
1 | a = [1, 2, 3] |
私有属性 和 私有方法
- 私有属性 就是 对象 不希望公开的 属性
- 私有方法 就是 对象 不希望公开的 方法
- 定义方式:
- 在 定义属性或方法时,在 属性名或者方法名前 增加 两个下划线,定义的就是 私有 属性或方法
- 私有属性只能被自己的方法调用
- 私有方法只能被自己的方法调用
1 | class Women: |
伪私有属性 和 私有方法
- 在日常开发中,不要使用这种方式,访问对象的 私有属性 或 私有方法
- Python 中,并没有 真正意义 的 私有
- 在给 属性、方法 命名时,实际是对 名称 做了一些特殊处理,使得外界无法访问到
- 处理方式:在 名称 前面加上
_类名=>_类名__名称
1 | print(xiaomei._Women__age) # 18 |
继承
-
继承:子类 拥有 父类 的所有 方法 和 属性
-
继承的语法:
1
2class 类名(父类名):
pass
1 | class Animal: |
方法的重写
- 子类 拥有 父类 的所有 方法 和 属性
- 子类 继承自 父类,可以直接 享受 父类中已经封装好的方法,不需要再次开发
- 当 父类 的方法实现不能满足子类需求时,可以对方法进行 重写(override)
1 | class Animal: |
super() 关键字
- super() 就是使用 super 类创建出来的对象
- 最常 使用的场景就是在 重写父类方法时,调用 在父类中封装的方法实现
1 | class Animal: |
父类的 私有属性 和 私有方法
- 子类对象 不能 在自己的方法内部,直接 访问 父类的 私有属性 或 私有方法
- 子类对象 可以通过 父类 的 公有方法 间接 访问到 私有属性 或 私有方法(父类在自己的公有方法中调用私有方法)
多继承
-
子类 可以拥有 多个父类,并且具有 所有父类 的 属性 和 方法
-
Python 中的 MRO —— 方法搜索顺序
-
Python 中针对 类 提供了一个 内置属性
__mro__可以查看 方法 搜索顺序 -
MRO 是 method resolution order,主要用于 在多继承时判断 方法、属性 的调用 路径
1
2
3print(C.__mro__)
# (<class '__main__.C'>, <class '__main__.A'>, <class '__main__.B'>, <class 'object'>)- 在搜索方法时,是按照
__mro__的输出结果 从左至右 的顺序查找的 - 如果在当前类中 找到方法,就直接执行,不再搜索,如果 没有找到,就查找下一个类 中是否有对应的方法,如果找到,就直接执行,不再搜索,如果找到最后一个类,还没有找到方法,程序报错
- 在搜索方法时,是按照
-
合并所有父类的 MRO 列表并遵循如下三条准则:
-
子类会先于父类被检查
-
多个父类会根据它们在列表中的顺序被检查
-
如果对下一个类存在两个合法的选择,选择第一个父类
-
-
多态
- Python实现多态的操作 就是 重写
- 多态 是 不同的对象调用同一个方法,实现不同的行为
- 多态 不同的 子类对象 调用相同的 父类方法,产生不同的执行结果
- 多态 可以 增加代码的灵活度
- 以 继承 和 重写父类方法 为前提
- 是调用方法的技巧,不会影响到类的内部设计
- 单一职责,开放 封闭 —对扩展开放,对修改封闭
常见问题 (总结)
例:找出102个数中出现 1 次的两个数
eg:
0000 0110 6
0000 1011 11
0000 1101 13 就是分成两堆
最低位: 0000 0001
1与6 按位与是假,和11按位与是真
1 | def find_list102_one(): |
format 的使用
eg:
1 | def use_format(): |
类属性 和 类方法
类的结构
- 使用面向对象开发,第 1 步 是设计 类
- 使用 类名() 创建对象,创建对象 的动作有两步:
- 在内存中为对象 分配空间
- 调用初始化方法 init 为 对象初始化
- 对象创建后,内存 中就有了一个对象的 实实在在 的存在 —— 实例

- 在 Python 中,类 是一个特殊的对象 —— 类对象
- 通过
类名.的方式可以 访问类的属性 或者 调用类的方法

eg:
1 | class Tool: |

-
因此,要访问类属性有两种方式:
类名.类属性对象.类属性(不推荐)
-
如果使用
对象.类属性 = 值赋值语句,只会 给对象添加一个属性,而不会影响到 类属性的值1
2
3
4
5
6
7
8
9
10
11
12
13
14
15class Tool:
count = 0
def __init__(self, name):
self.name = name
Tool.count += 1
if __name__ == '__main__':
too1 = Tool("锄头")
too2 = Tool("斧头")
too1.count = 99
print(Tool.count) # 2
print(too1.count) # 99
类方法 和 静态方法
类方法
(出现概率比较小)
-
类方法 就是针对 类对象 定义的方法
- 在 类方法 内部可以直接访问 类属性 或者调用其他的 类方法
-
语法:
1
2
3
def 类方法名(cls):
pass- 类方法需要用 修饰器
@classmethod来标识,告诉解释器这是一个 类方法 - 类方法的 第一个参数 应该是
cls- 由 哪一个类 调用的方法,方法内的
cls就是 哪一个类的引用 - 这个参数和 实例方法 的第一个参数是 self 类似
- 提示 使用其他名称也可以,不过习惯使用 cls
- 由 哪一个类 调用的方法,方法内的
- 通过
类名.调用 类方法,调用方法时,不需要传递 cls 参数 - 在方法内部
- 可以通过
cls.访问类的属性 - 也可以通过
cls.调用其他的类方法
- 可以通过
- 类方法需要用 修饰器
1 | class Tool: |
静态方法
-
既 不需要 访问 实例属性 或者调用 实例方法
-
也 不需要 访问 类属性 或者调用 类方法
-
语法如下:
1
2
3
def 静态方法名():
pass- 静态方法 需要用 修饰器
@staticmethod来标识,告诉解释器这是一个静态方法 - 通过
类名.调用 静态方法
- 静态方法 需要用 修饰器
1 | class Dog(object): |
eg:
1 | class Game: |
单例设计模式
- 设计模式
- 设计模式 是 前人工作的总结和提炼,通常,被人们广泛流传的设计模式都是针对 某一特定问题 的成熟的解决方案
- 使用 设计模式 是为了可重用代码、让代码更容易被他人理解、保证代码可靠性,可扩展性很好
- 单例设计模式
- 目的 —— 让 类 创建的对象,在系统中 只有 唯一的一个实例
- 每一次执行
类名()返回的对象,内存地址是相同的
- 使用场景
- 音乐播放 对象
- 回收站 对象
- 打印机 对象
__new__方法
__:两个_开头的都属于 内置方法,就是 object 自带的方法- 使用 类名() 创建对象时,Python 的解释器 首先 会 调用
__new__方法为对象分配空间 __new__是一个 由 object 基类提供的 内置的静态方法,主要作用有两个:- 在内存中为对象 分配空间
- 返回 对象的引用
- Python 的解释器获得对象的 引用 后,将引用作为 第一个参数,传递给
__init__方法 - 重写
__new__方法 的代码非常固定:- 重写
__new__方法 一定要 return super().new(cls) - 否则 Python 的解释器 得不到 分配了空间的 对象引用,就不会调用对象的初始化方法
- 重写
__new__是一个静态方法,在调用时需要 主动传递 cls 参数

1 | class MusicPlayer(object): |
Python中的单例
- 定义一个 类属性,初始值是 None,用于记录 单例对象的引用
- 重写 new 方法
- 如果 类属性 is None,调用父类方法分配空间,并在类属性中记录结果
- 返回 类属性 中记录的 对象引用

1 | # 借助类属性,外加重写 __new__ 方法实现单例模式 |
异常
- 程序在运行时,如果 Python 解释器 遇到 到一个错误,会停止程序的执行,并且提示一些错误信息,这就是 异常
- 程序停止执行并且提示错误信息 这个动作,我们通常称之为:抛出(raise)异常

-
捕获异常 的语法格式:
1
2
3
4try:
尝试执行的代码
except:
出现错误的处理eg:
1
2
3
4
5
6try:
# 提示用户输入一个数字
num = int(input("请输入数字:"))
except: # 出现异常才会走到except,有了except程序才不会崩溃
print("请输入正确的数字")
print(num) -
错误类型的捕获 的语法格式:
1
2
3
4
5
6
7
8
9
10
11try:
# 尝试执行的代码
pass
except 错误类型 1:
# 针对错误类型 1,对应的代码处理
pass
except (错误类型 2, 错误类型 3):
# 针对错误类型 2 和 3,对应的代码处理
pass
except Exception as result:
print("未知错误 %s" % result)eg:
1
2
3
4
5
6
7
8
9try:
# 提示用户输入一个数字
num = int(input("请输入数字:"))
result = 8 / num
print(result)
except ValueError:
print("请输入正确的整数")
except ZeroDivisionError:
print("除 0 错误") -
异常捕获 完整语法格式:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23try:
# 尝试执行的代码
pass
except 错误类型 1:
# 针对错误类型 1,对应的代码处理
pass
except 错误类型 2:
# 针对错误类型 2,对应的代码处理
pass
except (错误类型 3, 错误类型 4):
# 针对错误类型 3 和 4,对应的代码处理
pass
except Exception as result:
# 打印错误信息
print(result)
else:
# else 下面的代码如果有异常,进程会直接结束
# 没有异常才会执行的代码
pass
finally:
# 为了让阅读代码者知道这里是一个整体
# 无论是否有异常,都会执行的代码
print("无论是否有异常,都会执行的代码")- else 只有在没有异常时才会执行的代码
- finally 无论是否有异常,都会执行的代码
-
Python 捕获异常发生的文件和具体行数
1
2
3
4
5
6try:
print(a) # 这里是异常
except Exception as e:
print(e)
print(e.__traceback__.tb_frame.f_globals["__file__"]) # 发生异常所在的文件
print(e.__traceback__.tb_lineno) # 发生异常所在的行号
Python 的异常汇总
- 标粗的比较重要!!!


-
断言异常 AssertionError
1
2
3
4
5
6
7
8
9# 类似于 if/else 表达式
try:
# assert 1 == 1
assert 1 == 0
except AssertionError:
print("断言异常")
# 断言异常
异常的传递
- 异常的传递 —— 当 函数/方法 执行 出现异常,会 将异常传递 给 函数/方法的 调用一方
- 如果 传递到主程序,仍然 没有异常处理,程序才会被终止
1 | def demo1(): |
抛出 raise 异常
- 在开发中,除了 代码执行出错 Python 解释器会 抛出 异常之外
- 可以根据 应用程序 特有的业务需求 主动抛出异常
- Python 中提供了一个 Exception 异常类
- 在开发时,如果满足 特定业务需求时,希望 抛出异常,可以:
- 创建 一个 Exception 的 对象
- 使用 raise 关键字 抛出 异常对象
- 在开发时,如果满足 特定业务需求时,希望 抛出异常,可以:
1 | """ |
创建自定义异常 — python3-cookbook 2.0.0 文档 (python-cookbook.readthedocs.io)
模块 和 包
- 每一个以扩展名 py 结尾的 Python 源代码文件都是一个 模块
- 模块名 同样也是一个 标识符,需要符合标识符的命名规则
- 模块 就好比是 工具包,要想使用这个工具包中的工具,就需要先 导入 这个模块
模块的导入
-
import导入1
2
3
4
5
6import 模块名 1, 模块名 2
# 提示:在导入模块时,每个导入应该独占一行
import 模块名 1
import 模块名 2-
如果模块的名字太长,可以使用
as指定模块的名称1
import 模块名 1 as 模块别名
eg:
1
2
3import test_module
import test_module as DogModule -
-
from ... import导入- 希望 从某一个模块 中,导入 部分 工具,就可以使用 from … import 的方式
- import 模块名 是 一次性 把模块中 所有工具全部导入,并且通过 模块名/别名访问
1
2# 从 模块 导入 某一个工具
from 模块名 1 import 工具名- 导入之后
- 不需要 通过
模块名.,可以直接使用 模块提供的工具 —— 全局变量、函数、类
- 不需要 通过
eg:
1
2
3
4
5from test_module1 import Dog
from test_module2 import say_hello
wangcai = Dog()
say_hello()1
2
3
4
5
6
7
8
9from test_module import *
import test_module
# 两者区别
# 如果都调用Dog()
# 第一种
Dog()
# 第二种
test_module.Dog()
模块的搜索顺序
-
Python 的解释器在 导入模块 时:
-
搜索 当前目录 指定模块名的文件,如果有就直接导入
-
如果没有,再搜索 系统目录(外部库,就是调用的包)
-
-
Python 中每一个模块都有一个内置属性
__file__可以 查看模块 的 完整路径
原则 : 每一个文件都应该是可以被导入的
__name__属性__name__是 Python 的一个内置属性,记录着一个 字符串- 如果 是被其他文件导入的,
__name__就是 模块名 - 如果 是当前执行的程序
__name__是__main__
eg:
1 | def main(): |
包 的概念
-
包 是一个 包含多个模块 的 特殊目录
-
目录下有一个 特殊的文件
__init__.py -
包名的 命名方式 和变量名一致,小写字母 + _
-
好处:
- 使用 import 包名 可以一次性导入 包 中 所有的模块
-
__init__.py-
要在外界使用 包 中的模块,需要在
__init__.py中指定 对外界提供的模块列表1
2
3
4# 在 __init__.py 文件中写入下列语句
# 从 当前目录 导入 模块列表
from . import send_message
from . import receive_message
-
发布模块
-
创建 setup.py 文件
- 在 要打包的包外面创建,与要打包的包一起组成一个软件包
1
2
3
4
5
6
7
8
9from distutils.core import setup
setup(name="hc_message", # 包名
version="1.0", # 版本
description="coo1heisenberg's 发送和接收消息模块", # 描述信息
long_description="完整的发送和接收消息模块", # 完整描述信息
author="coo1heisenberg", # 作者
author_email="hc_one1@163.com", # 作者邮箱
url="www.coo1heisenberg.github.io", # 主页
py_modules=["hc_message.send_message","hc_message.receive_message"]) # 有哪些模块 -
构建模块(Ubuntu 和 windows 都可以)
1
python3 setup.py build
-
生成发布压缩包
1
python3 setup.py sdist
安装模块
1 | tar xf hc_message-1.0.tar.gz |
-
卸载模块
1
2cd /usr/local/lib/python3.6/dist-packages/
sudo rm -r hc_message*
pip 安装第三方模块
-
第三方模块 通常是指由 知名的第三方团队 开发的 并且被 程序员广泛使用 的 Python 包 / 模块
-
在Ubuntu下安装pip
1
sudo apt install python3-pip
-
验证 pip 是否装好
1
2
3pip3 -V
pip 9.0.1 from /usr/lib/python3/dist-packages (python 3.6) -
在 Ubuntu 下修改 pip (python) 安装源
-
mkdir .pip文件夹 -
在
~/.pip目录下,新建pip.conf -
写入以下内容
1
2
3
4[global]
timeout = 6000
index-url = https://pypi.mirrors.ustc.edu.cn/simple/
trusted-host = pypi.mirrors.ustc.edu.cn
-
-
在windows下操作,同样要改 pip 安装源
-
进入 C:\Users\Administrator\AppData\Roaming
-
创建文件夹 C:\Users\Administrator\AppData\Roaming\pip
-
新建 pip.ini 文件
-
写入以下内容
1
2
3
4[global]
timeout = 6000
index-url = https://pypi.mirrors.ustc.edu.cn/simple/
trusted-host = pypi.mirrors.ustc.edu.cn- 注意:下载的时候不要挂VPN
-
-
在 PyCharm 修改 pip 安装源
文件操作
在 计算机 中要操作文件的套路非常固定,一共包含三个步骤:
-
打开文件
-
读、写文件
- 读 将文件内容读入内存
- 写 将内存内容写入文件
-
关闭文件
操作文件的函数 / 方法
| 序号 | 函数 / 方法 | 说明 |
|---|---|---|
| 1 | open | 打开文件,并且返回文件操作对象 |
| 2 | read | 将文件内容读取到内存 |
| 3 | write | 将指定内容写入文件 |
| 4 | close | 关闭文件 |
- open 函数的第一个参数是要打开的文件名(文件名区分大小写)
- 如果文件 存在,返回 文件操作对象
- 如果文件 不存在,会 抛出异常
- read 方法可以一次性 读入 并 返回 文件的 所有内容
- close 方法负责 关闭文件
- 如果 忘记关闭文件,会造成系统资源消耗,而且会影响到后续对文件的访问
- 注意:read 方法执行后,会把 文件指针 移动到 文件的末尾
- 如果读到结尾再读,会得到空的字符串
1 | def use_open(): |
打开文件的方式
- open 函数默认以 只读方式 打开文件,返回文件对象
1 | f = open("文件名", "访问方式") |
| 访问方式 | 说明 |
|---|---|
| r | 以只读方式打开文件。文件的指针将会放在文件的开头,这是默认模式。如果文件不存在,抛出异常 |
| w | 以只写方式打开文件。如果文件存在会被覆盖。如果文件不存在,创建新文件,与 r+ 的区别是 w会清空文件, r+ 不会清空文件 |
| a | 以追加方式打开文件。如果该文件已存在,文件指针将会放在文件的结尾。如果文件不存在,创建新文件进行写入,只能写,不能读 |
| r+ | 以读写方式打开文件。文件的指针将会放在文件的开头。如果文件不存在,抛出异常 |
| w+ | 以读写方式打开文件。如果文件存在会被覆盖。如果文件不存在,创建新文件 |
| a+ | 以读写方式打开文件。如果该文件已存在,文件指针将会放在文件的结尾。如果文件不存在,创建新文件进行写入 |
1 | def use_write(): |
readline 方法
- readline 方法可以一次读取一行内容
- 方法执行后,会把 文件指针 移动到下一行,准备再次读取
1 | def use_readline(): |
seek 的使用
-
文件指针定位
1
seek(offset, from)
- offset :文件指针偏移量(很多博客在这里将 offset 定义为指针偏移量,但是目前我的看法是这里定义为指针的相对位置)
- from : 0-文件开头、1-当前位置、2-文件末尾 (这里的 0,1,2 只是代表了文件位置,而不是说 0,1,2 可以参与指针偏移的计算。from 是可选项,默认为 0)
- 二进制模式下才可以往前偏移,二进制模式下 offset 才能为负值
- 当有汉字时,seek填写的必须是3的整数倍,否则报错
1 | # 使用 seek 对位置指针进行偏移 |
w 和 wb 模式的差异
-
wb 模式:只写的二进制模式,而二进制模式打开得到的是字节流,二进制模式上磁盘存的是什么字符,直接拿出来
- b 模式:得到的是字节流,在b模式下执行open要把encoding删去
-
w 模式:只写的文本模式,而文本模式下,
\r\n拿出来是\n
文件 / 目录的常用管理操作
- 在 终端 / 文件浏览器、 中可以执行常规的 文件 / 目录 管理操作,例如:创建、重命名、删除、改变路径、查看目录内容 …
- 在 Python 中,如果希望通过程序实现上述功能,需要导入 os 模块
文件操作
| 序号 | 方法名 | 说明 | 示例 |
|---|---|---|---|
| 1 | rename | 重命名文件 | os.rename(源文件名, 目标文件名) |
| 2 | remove | 删除文件,不能删除文件夹 | os.remove(文件名) |
目录操作
| 序号 | 方法名 | 说明 | 示例 |
|---|---|---|---|
| 1 | listdir | 目录列表 | os.listdir(目录名) |
| 2 | mkdir | 创建目录 | os.mkdir(目录名) |
| 3 | rmdir | 删除目录 | os.rmdir(目录名) |
| 4 | getcwd | 获取当前目录 | os.getcwd() |
| 5 | chdir | 修改工作目录 | os.chdir(目标目录) |
| 6 | path.isdir | 判断是否是文件夹 | os.path.isdir(文件路径) |
1 | import os |
eval 函数
- 将字符串 当成 有效的表达式 来求值 并 返回计算结果
eg:
1 | print(eval("1 + 1")) # 2 |
-
在开发时千万不要使用 eval 直接转换 input 的结果
1
2
3# 存在安全风险
# 不要用eval去执行前端传递过来的字符串
eval("__import__('os').system('rm -rf /')")
Python常用数据结构与算法
栈
-
Python代码定义:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20class Stack:
def __init__(self):
self.stack = [] # 使用列表实现
def push(self, ele):
self.stack.append(ele)
def pop(self):
return self.stack.pop()
def top(self):
if self.empty():
return "stack is empty"
return self.stack[-1] # 切片,获取列表末尾元素
def empty(self):
return self.stack == []
def size(self):
return len(self.stack)
队列
-
Python代码定义:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18# 循环队列
from collections import deque
# 增删查改
queue = deque(["Eric", "John", "Michael"])
queue.append('luke')
print(queue)
# deque(['Eric', 'John', 'Michael', 'luke'])
print(queue.popleft()) # 左边出队
# Eric
print(queue)
# deque(['John', 'Michael', 'luke'])
queue[0] = 'xiongda'
print(queue[0])
# xiongda-
判断循环队列 满:
1
(rear + 1) % MaxSize == front
-
判断循环队列 空:
1
rear == front
-
二叉树
-
二叉树的节点的定义
1
2
3
4
5
6
7
8class Node(object):
"""节点类"""
def __init__(self, elem=-1, lchild=None, rchild=None):
self.elem = elem
self.lchild = lchild
self.rchild = rchild -
二叉树的建树
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63class Tree:
def __init__(self):
self.root = None
self.queue = [] # 创建一个辅助队列
# 层序遍历建树
def insert_node(self, elem):
new_node = Node(elem) # 对新节点进行初始化
self.queue.append(new_node) # 放入队列
if self.root is None:
self.root = new_node # 树为空,new_node就为树根
else:
if self.queue[0].lchild is None: # 判断左孩子是否为空
self.queue[0].lchild = new_node
elif self.queue[0].rchild is None: # 判断右孩子是否为空
self.queue[0].rchild = new_node
self.queue.pop(0) # 出队
# 先序遍历
def preorder(self, current_node: Node): # current_node: Node 指定current_node类型
if current_node is not None:
print(current_node.elem, end=" ")
self.preorder(current_node.lchild)
self.preorder(current_node.rchild)
# 中序遍历
def midorder(self, current_node: Node): # current_node: Node 指定current_node类型
if current_node is not None:
self.midorder(current_node.lchild)
print(current_node.elem, end=" ")
self.midorder(current_node.rchild)
# 后序遍历
def postorder(self, current_node: Node): # current_node: Node 指定current_node类型
if current_node is not None:
self.postorder(current_node.lchild)
self.postorder(current_node.rchild)
print(current_node.elem, end=" ")
if __name__ == '__main__':
tree = Tree()
for i in range(1, 11):
tree.insert_node(i)
tree.preorder(tree.root)
print()
tree.midorder(tree.root)
print()
tree.postorder(tree.root)
"""
1 2 4 8 9 5 10 3 6 7
8 4 9 2 10 5 1 6 3 7
8 9 4 10 5 2 6 7 3 1
"""
排序算法

冒泡排序
- i 很大,内层循环从前象后比,把最大的冒泡放到最后,i 不断减小,最终达到有序

1 | # 冒泡排序 |
选择排序
- min_pos 记录最小的,每一轮比较知道最小的是谁,放到最前面,i 变大,最终达到有序

1 | # 选择排序 |
插入排序
- 把前面数据作为有序序列,后面的数不断的插入到前面的有序序列中

1 | # 插入排序 |
希尔排序


1 | # 希尔排序 |
快速排序
- 分治思想,一轮比较,把小的数放到左边,大的数放到右边,分割值已经排好,递归左边的

1 | # 快速排序 |
堆排序


1 | ### 大根堆 |
归并排序
- 数组一分为二,把low到mid递归变为有序,把mid+1到high递归变为有序,通过merge合并两个有序数组
1 | # 归并排序 |
计数排序
1 | # 计数排序 |
排序算法的时间比较
1 | import time |

常见面试题
-
N 个无序数的数组,让找出第 K 大的数?
- 对前 K 个元素建立小根堆,遍历数组元素,发现比堆顶元素要大,淘汰堆顶元素,把这个元素放入堆顶,重新调整为小根堆,循环往复,到最后。时间复杂度为
O(NlogK) - 也可以用快速排序,通过分隔值分为两块,把比分隔值小的那部分数删除掉,然后再快排比分隔值大的,循环往复,找到K个数。
O(N) -> O(N/2) -> O(N/4) -> O(N/8) -> O(N/16) ...
- 对前 K 个元素建立小根堆,遍历数组元素,发现比堆顶元素要大,淘汰堆顶元素,把这个元素放入堆顶,重新调整为小根堆,循环往复,到最后。时间复杂度为
-
如果内存无法存储 K 个元素怎么办?
- 这是一个逆向思维的问题,假如内存可以存下 N-K+1 个元素,我们首先建立 N-K+1 元素的大根堆,这时依次遍历数组,如果发现某个元素小于堆顶,这时移除堆顶,将新元素放入,重新调整为大根堆,这时遍历到数组末尾,堆顶元素即为第 N-K+1 小的,所以也就是第 K 大的。
-
刚才找的第 K 大的元素是没有考虑重复元素的问题,现在要找的第 K 大是不含有重复元素的第 K 大?
-
建立小根堆时,重复的元素不放入,通过计数排序去重
-
位图是最快快的去重方法(采用空间换时间)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33# 位图去重
class BitMap:
def __init__(self):
self.bitmap = 0
self.arr = [9, 20, 17, 16, 3, 4, 8, 2, 7, 9, 4, 3]
self.new_arr = []
def duplicate_remove(self):
for i in self.arr:
if self.bitmap & 1 << i: # 按位 与
pass
else:
self.new_arr.append(i)
self.bitmap |= 1 << i # 按位 或
if __name__ == '__main__':
bitmap = BitMap()
bitmap.duplicate_remove()
print(bitmap.new_arr)
# [9, 20, 17, 16, 3, 4, 8, 2, 7]
"""
按位与运算符(&)
运算规则:0 & 0 = 0; 0 & 1 = 0; 1 & 0 = 0; 1 & 1 = 1;
按位或运算符(|)
运算规则:0 | 0 = 0;0 | 1 = 1;1 | 0 = 1;1 | 1 = 1;
异或运算符(^)
运算规则:0^0=0; 0^1=1; 1^0=1; 1^1=0;
""" -
字典树:用于字符串的去重

-
-
如果单台机器的内存即不能存储 K 个元素,也无法存储 N-K 个元素,如何使用多机排序找出第 K 大的元素?
- 如果内存放不下,又不可以多机排序,这时只能使用外部排序,外部排序,首先是将数据切分为 k 块,每一块可以放入内存排序后,重新写回,然后针对 k 块数据采用多路归并(败者树的多路归并思想)
- 败者树(Loser Tree)是一种特殊的完全二叉树结构,主要用于选择算法和归并排序中。它的设计初衷是为了高效地从多个已排序序列中选择最小或最大元素
- 如果内存放不下,又不可以多机排序,这时只能使用外部排序,外部排序,首先是将数据切分为 k 块,每一块可以放入内存排序后,重新写回,然后针对 k 块数据采用多路归并(败者树的多路归并思想)
-
总计 25 匹马,5 条赛道,一匹马一个赛道,比赛只能得到 5 匹马之间的快慢程度,请问至少需要比几次,才能得到前三名
- A 组:A1,A2,A3,A4,A5
- B 组:B1,B2,B3,B4,B5
- C 组:C1,C2,C3,C4,C5
- D 组:D1,D2,D3,D4,D5
- E 组:E1,E2,E3,E4,E5
- 假设每组的马的速度是 X1>X2>X3>X4>X5,(X= A,B,C…)
- 首先每组的 5 匹马的比赛是避免不了的,根据每组的快慢且找出最快的前 3 匹马
- 再将每组的第一名:A1,B1,C1,D1,E1五匹马拿出来比赛,假设结果为:A1>B1>C1>D1>E1
- A 组:A1,A2,A3
- B 组:B1,B2,B3
- C 组:C1,C2,C3
- 接下来把 A2,B1,A3,B2,C1。这五匹马再进行一场比赛即可确定全场第二与第三
- 总共进行 7 场比赛可以确定最快的前三匹马
二分查找
1 | def binary_search(arr, target): |
- 二分查找的时间复杂度为
O(logn)
哈希查找
-
用到一个列表,通过一个 F(x) 公式得到的一个下标值,必须是 0-999 之间 放到这个列表中
-
获取 ASCII 码值
1
print(ord("a")) # 获得这个 a 的ASCII码为 97
1 | def elf_hash(hash_str): |
sort 常用场景
基本排序 Sorting Basics
- sort 函数是 list 列表中的函数,而 sorted 可以对 list 或者 iterator 进行排序
- sort 和 sorted 的比较
- 用 sort 函数对列表排序时会影响列表本身,而 sorted 不会
eg:
1 | l = [5, 2, 3, 1, 4] |
列表内存存储及列表的算法效率
| 列表的操作 | 时间复杂度 |
|---|---|
| index() | O(1) |
| append | O(1) |
| pop() | O(1) |
| pop(i) | O(n) |
| insert(i,item) | O(n) |
| del operator | O(n) |
| iteration | O(n) |
| contains(in) | O(n) |
| get slice[x:y] | O(k) |
| del slice | O(n) |
| set slice | O(n+k) |
| reverse | O(n) |
| concatenate | O(k) |
| sort | O(nlogn) |
| multiply (eg:[1, 2, 3] * 2,一般初始化用的比较多) | O(nk) |
key 函数 Key Functions
-
def sort_str(): l = "This is the first line in the Bible from Andrew".split() print(l) # ['This', 'is', 'the', 'first', 'line', 'in', 'the', 'Bible', 'from', 'Andrew'] print(sorted(l, key=str.lower)) # ['Andrew', 'Bible', 'first', 'from', 'in', 'is', 'line', 'the', 'the', 'This']1
2
3
4
5
6
7
8
9
10
11
12
13
2. ```python
def sort_list_tuple():
student_tuples = [
('john', 'A', 15),
('jane', 'B', 12),
('dave', 'B', 10),
]
print(sorted(student_tuples, key=lambda i: i[2]))
# 后面这个lambda中i是可以随便命名的
# i:i[2] 表示 i是每一个元组,i[2] 表示每一个元组的第二个元素
# [('dave', 'B', 10), ('jane', 'B', 12), ('john', 'A', 15)] -
class Student: def __init__(self, name, grade, age): self.name = name self.grade = grade self.age = age # 功能和之前的__str__差不多,但是比__str__更加灵活 # 但是__repr__可以返回任何类型 def __repr__(self): return repr((self.name, self.grade, self.age)) student_objects = [ Student('john', 'A', 15), Student('jane', 'B', 12), Student('dave', 'B', 10), ] # 排序的列表是自定义的object def sort_list_object(): print(sorted(student_objects, key=lambda stu: stu.age)) sort_list_object() # [('dave', 'B', 10), ('jane', 'B', 12), ('john', 'A', 15)]1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
---
### operator 库函数自定义排序
- operator 库提供了 itemgetter(), attrgetter(), and a methodcaller()三个函数
```python
from operator import itemgetter, attrgetter
student_objects = [
Student('john', 'A', 15),
Student('jane', 'B', 12),
Student('dave', 'B', 10), ]
def use_operator():
student_tuples = [
('john', 'A', 15),
('jane', 'B', 12),
('dave', 'B', 10),
]
print(sorted(student_tuples, key=itemgetter(2)))
# [('dave', 'B', 10), ('jane', 'B', 12), ('john', 'A', 15)]
print(sorted(student_objects, key=attrgetter("age")))
# [('dave', 'B', 10), ('jane', 'B', 12), ('john', 'A', 15)]
print(sorted(student_tuples, key=itemgetter(1, 2)))
# itemgetter(1, 2):先按第一个元素排,然后再按第二个元素排
# [('john', 'A', 15), ('dave', 'B', 10), ('jane', 'B', 12)]
1 | def use_stability(): |
字典中混合 list 排序
1 | def dict_list(): |
List 中混合字典排序
针对 list 中的字典元素按照 rating 和 name 进行排序的实现方法
1 | from operator import itemgetter |
红黑树
- 红黑树(英语:Red–black tree)是一种自平衡二叉查找树
- 红黑树相对于 AVL 树的时间复杂度是一样的,但是优势是当插入或者删除节点时,红黑树实际的调整次数更少,旋转次数更少,因此红黑树插入删除的效率高于 AVL 树,大量中间件产品中使用了红黑树
红黑树的特点
- 节点是红色或黑色
- 根是黑色
- 所有叶子节点都是黑色(叶子是 NIL 节点)
- 每个红色节点必须有两个黑色的子节点。(从每个叶子到根的所有路径上不能有两个连续的红色节点)
- 从任一节点到其每个叶子的所有简单路径都包含相同数目的黑色节点
- 从根节点出发到任意一个节点的黑色节点数相同
- 口诀:左根右,根叶黑,黑路同,不红红

红黑树的插入
-
情形 1: 新节点 N 位于树的根上,没有父节点,这种情况就是红黑树没有其他节点,只有根节点,那就直接标记会黑色,或者时经过调整后,红黑树的根节点被变为红色了,那就直接把它图为黑色。
-
情形 **2:**新节点的父节点 P 是黑色,所以性质 4 没有失效(新节点是红色的)。在这种情形下,树仍是有效的。性质 5 也未受到威胁,尽管新节点 N 有两个黑色叶子子节点;但由于新节点 N 是红色,通过它的每个子节点的路径就都有同通过它所取代的黑色的叶子的路径同样数目的黑色节点,所以依然满足这个性质
-
情形 3:如果父节点 P 和叔父节点 U 二者都是红色

-
情形 **4:**父节点 P 是红色而叔父节点 U 是黑色或缺少,并且新节点 N 是其父节点 P 的右子节点而父节点 P 又是其父节点的左子节点

-
情形 5:父节点 P 是红色而叔父节点 U 是黑色或缺少,新节点 N 是其父节点的左子节点,而父节点 P 又是其父节点 G 的左子节点

-
图形总结

-
针对情形四,叔叔不存在或者是黑色,就需要对父亲 P 进行相应的旋转,旋转后刚好变成了对应自己下方情形五的样子,然后再对爷爷 G 进行相应的旋转即可
-
代码演示
-
红黑树的插入主要分成两步:
- 先找到位置放入
- 调整
-
定义红黑树节点
1
2
3
4
5
6
7
8# 定义一个红黑树
class RedBlackTreeNode(object):
def __init__(self, value):
self.value = value
self.left = None # 当前节点的左孩子
self.right = None # 当前节点的右孩子
self.p = None # 当前节点的父亲
self.color = RED -

-
代码实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20# 红黑树的左旋
# node:要旋转的节点,对应图里的x
# tree:树根
def left_rotate(tree, node):
# 没有右孩子,就不用左旋了
if not node.right:
return False
node_right = node.right
node_right.p = node.p
if not node.p: # 如果node没有父亲,node就是根,右旋之后node_right是根
tree.root = node_right
elif node == node.p.left: # node是在父亲的左边
node.p.left = node_right
else:
node.p.right = node_right
if node_right.left:
node_right.left.p = node
node.right = node_right.left
node.p = node_right
node_right.left = node
-
-

-
代码实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17# 红黑树的右旋
def right_rotate(tree, node):
if not node.left:
return False
node_left = node.left
node_left.p = node.p
if not node.p:
tree.root = node_left # 改变树根
elif node == node.p.left: # node是父亲的左孩子
node.p.left = node_left
elif node == node.p.right: # node是父亲的右孩子
node.p.right = node_left
if node_left.right:
node_left.right.p = node
node.left = node_left.right
node.p = node_left
node_left.right = node
-
-
红黑树的调整 及插入
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70class RedBlackTree:
def __init__(self):
self.root: RedBlackTreeNode = None
# 放入二叉排序树
def insert(self, node: RedBlackTreeNode):
# 如果树根为空
if not self.root:
self.root = node
else:
x = self.root
while x: # 当x为None时,y恰好是要放入的父亲
y = x
if node.value > x.value:
x = x.right
else:
x = x.left
node.p = y
if node.value > y.value:
y.right = node
else:
y.left = node
self.insert_fixup(node)
# 颜色调整以及 插入后的旋转
def insert_fixup(self, node):
parent: RedBlackTreeNode = node.p
# 父亲存在,且父亲是红色
while parent and parent.color == RED:
grandpa: RedBlackTreeNode = parent.p
if parent == grandpa.left:
uncle: RedBlackTreeNode = grandpa.right
# 判断情形3
if uncle and uncle.color == RED:
parent.color = BLACK
uncle.color = BLACK
grandpa.color = RED
node = grandpa # 爷爷重新作为孩子进行调整
parent = node.p
continue
# 判断情形4
if node == parent.right:
left_rotate(self, parent)
node, parent = parent, node
# 情形4之后必做情形5
right_rotate(self, grandpa)
parent.color = BLACK
grandpa.color = RED
else:
uncle: RedBlackTreeNode = grandpa.left
# 判断情形3
if uncle and uncle.color == RED:
parent.color = BLACK
uncle.color = BLACK
grandpa.color = RED
node = grandpa # 爷爷重新作为孩子进行调整
parent = node.p
continue
# 判断情形4
if node == parent.left:
right_rotate(self, parent)
node, parent = parent, node
# 情形4之后必做情形5
left_rotate(self, grandpa)
parent.color = BLACK
grandpa.color = RED
self.root.color = BLACK
-
-
整体代码汇总:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165# 红黑树 Python 实现
# 颜色常量
RED = 0
BLACK = 1
# 定义一个红黑树
class RedBlackTreeNode(object):
def __init__(self, value):
self.value = value
self.left = None # 当前节点的左孩子
self.right = None # 当前节点的右孩子
self.p = None # 当前节点的父亲
self.color = RED
# 红黑树的左旋
# node:要旋转的节点,对应图里的x
# tree:树根
def left_rotate(tree, node):
# 没有右孩子,就不用左旋了
if not node.right:
return False
node_right = node.right
node_right.p = node.p
if not node.p: # 如果node没有父亲,node就是根,右旋之后node_right是根
tree.root = node_right
elif node == node.p.left: # node是在父亲的左边
node.p.left = node_right
else:
node.p.right = node_right
if node_right.left:
node_right.left.p = node
node.right = node_right.left
node.p = node_right
node_right.left = node
# 红黑树的右旋
def right_rotate(tree, node):
if not node.left:
return False
node_left = node.left
node_left.p = node.p
if not node.p:
tree.root = node_left # 改变树根
elif node == node.p.left: # node是父亲的左孩子
node.p.left = node_left
elif node == node.p.right: # node是父亲的右孩子
node.p.right = node_left
if node_left.right:
node_left.right.p = node
node.left = node_left.right
node.p = node_left
node_left.right = node
class RedBlackTree:
def __init__(self):
self.root: RedBlackTreeNode = None
# 放入二叉排序树
def insert(self, node: RedBlackTreeNode):
# 如果树根为空
if not self.root:
self.root = node
else:
x = self.root
while x: # 当x为None时,y恰好是要放入的父亲
y = x
if node.value > x.value:
x = x.right
else:
x = x.left
node.p = y
if node.value > y.value:
y.right = node
else:
y.left = node
self.insert_fixup(node)
# 颜色调整以及 插入后的旋转
def insert_fixup(self, node):
parent: RedBlackTreeNode = node.p
# 父亲存在,且父亲是红色
while parent and parent.color == RED:
grandpa: RedBlackTreeNode = parent.p
if parent == grandpa.left:
uncle: RedBlackTreeNode = grandpa.right
# 判断情形3
if uncle and uncle.color == RED:
parent.color = BLACK
uncle.color = BLACK
grandpa.color = RED
node = grandpa # 爷爷重新作为孩子进行调整
parent = node.p
continue
# 判断情形4
if node == parent.right:
left_rotate(self, parent)
node, parent = parent, node
# 情形4之后必做情形5
right_rotate(self, grandpa)
parent.color = BLACK
grandpa.color = RED
else:
uncle: RedBlackTreeNode = grandpa.left
# 判断情形3
if uncle and uncle.color == RED:
parent.color = BLACK
uncle.color = BLACK
grandpa.color = RED
node = grandpa # 爷爷重新作为孩子进行调整
parent = node.p
continue
# 判断情形4
if node == parent.left:
right_rotate(self, parent)
node, parent = parent, node
# 情形4之后必做情形5
left_rotate(self, grandpa)
parent.color = BLACK
grandpa.color = RED
self.root.color = BLACK
def rbtree_print(node, key, direction):
if node:
if direction == 0: # tree 是根节点
print("%2d(B) is root" % node.value)
else: # tree 是分支节点
print("%2d(%s) is %2d's %6s child" % (
node.value, ("B" if node.color == 1 else "R"), key, ("right" if direction == 1 else "left")))
rbtree_print(node.left, node.value, -1)
rbtree_print(node.right, node.value, 1)
def main():
number_list = (7, 4, 1, 8, 5, 2, 9, 6, 3)
tree = RedBlackTree()
for number in number_list:
node = RedBlackTreeNode(number)
tree.insert(node)
rbtree_print(tree.root, tree.root.value, 0)
if __name__ == '__main__':
main()
"""
4(B) is root
2(B) is 4's left child
1(R) is 2's left child
3(R) is 2's right child
7(R) is 4's right child
5(B) is 7's left child
6(R) is 5's right child
8(B) is 7's right child
9(R) is 8's right child
"""
红黑树的删除
-
情形 1: N 是新的根。在这种情形下,我们就做完了。我们从所有路径去除了一个黑色节点,而新根是黑色的,所以性质都保持着。
-
情形 2:S 是红色。在这种情形下我们在 N 的父亲上做左旋转,把红色兄弟转换成 N 的祖父,我们接着对调 N 的父亲和祖父的颜色。完成这两个操作后,尽管所有路径上黑色节点的数目没有改变,但现在 N 有了一个黑色的兄弟和一个红色的父亲(它的新兄弟是黑色因为它是红色 S 的一个儿子),所以我们可接下去按情形 4、情形 5 或情形 6来处理

-
**情形 3:**N 的父亲、S 和 S 的儿子都是黑色的,如图 4.1.4.2-3 所示。在这种情形下,我们简单的重绘 S 为红色

-
**情形 4:**S 和 S 的儿子都是黑色,但是 N 的父亲是红色,如图 4.1.4.2-4 所示,在这种情形下,我们简单的交换 N 的兄弟和父亲的颜色

-
情形 5:S 是黑色,S 的左儿子是红色,S 的右儿子是黑色,而 N 是它父亲的左儿子,如图4.1.4.2-5 所示。在这种情形下我们在 S 上做右旋转,这样 S 的左儿子成为 S 的父亲和 N 的新兄弟。我们接着交换 S 和它的新父亲的颜色。所有路径仍有同样数目的黑色节点,但是现在N 有了一个黑色兄弟,他的右儿子是红色的,所以我们进入了情形 6。N 和它的父亲都不受这个变换的影响

-
情形 6: S 是黑色,S 的右儿子是红色,而 N 是它父亲的左儿子,如图 4.1.4.2-6 所示。在这种情形下我们在 N 的父亲上做左旋转,这样 S 成为 N 的父亲(P)和 S 的右儿子的父亲。我们接着交换 N 的父亲 P(无论 P 是黑色还是红色都可以,所以图 4.1.4.2-6 中标注 R/B,即 red或者 black 都可以)和 S 的颜色,并使 S 的右儿子为黑色

图形总结:

- N 就是 NIL
- 总结:
- p 黑, s 红, p 左旋
- p 黑, s 黑, s 变红
- p 红, s 黑, 颜色互换
- s 黑, SL 红, s 右旋, s、SL 颜色互换
- s 黑, SR 红, p 左旋, p、s 颜色互换


